VS 카드 사전 52장

발표로 돌아가기(4장 측정 체계)6장 평가 보드

평가 카드 52장(기본 m 48장 · 기본 m 밖 4장)의 정의, 측정 방법, 신뢰도, 2,000 운영 조건 결과, 사례, 출처. 값은 30b 카드 자료(generation 20261024T100739Z-a75be5ef)에서 읽었고 판정은 모두 모델(LLM)과 규칙이다.

생성 · 질의 단위 · 기본 m

G0 정답 재현(생성)

띠 운영 조건 값 없음

무엇

이름
정답 재현(생성)
링크
생성
단위(셀)
질의
기본 m
기본 m 정답 기준 띠(도달 계산 밖)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
same같음
different다름결함

기본 m 근거(53 문서)

절
2 정답 기준 정상 작동 띠(근거 열 없음)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
0–2%
53 달성
미달

무엇을 잡나

정답 원문을 넣었을 때 생성이 정답 YAML 과 다른 유형, 빠진 항목, 뒤집힌 순서, 다른 표 모양, 다른 params 를 내는 일을 잡는다. 운영 카드 G1, G3–G6 은 원문 대비 적합만 보아 정답과의 일치를 볼 자리가 없으므로, 정답 조건에서 따로 재는 「정답 기준」 띠 카드다(평가틀 47 결정 6). 생성 링크의 책임이고 비교 대상은 정답 YAML 이며, 운영 도달 계산에는 넣지 않는다(같은 결정).

어떻게

질문

정답 원문(조건 a)에서 만든 생성 YAML 이 정답 YAML 과 같은가. 아래 하위 판정 가운데 하나라도 결함이면 다르다.
- 유형(G1 사다리): 생성 유형이 정답 유형과 같거나 정답 유형의 fallback 사다리 아래쪽이면 같다. 그 밖이면 결함.
- 항목(G3): 정답 entity 이름 가운데 생성에 없는 것이 하나라도 있으면 결함(안내문, 자리표시 글은 세지 않고, 문서 제목 등으로 옮겨 간 이름은 있는 것으로 본다).
- 순서(G4): 짝지은 항목의 상대 순서가 하나라도 뒤집히면 결함.
- 표 모양(G5): 정답 dataset 과 행, 열이 바뀌었거나 다르면 결함(칸 글이 모두 같으면 같다).
- params(G6): 정답 params 키 가운데 생성 값이 다른 것이 있으면 결함(생략은 세지 않는다).
입력 자료
source_text query_yaml gold_yaml
측정기
규칙
정답 종류
rule · 규칙 gold_generation_repro
비교 기준
정답 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
rule_extra = gold_generation_reasons, 집계 = ratio
카드 버전
v1

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 띠

한계

  • O 2,000 값 없음: 정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)
  • 관문(25 문서 3절): 정답 기준 띠(운영 도달 계산 밖, 47 결정 6)

결과

자료 없음

기준값과 판정(6장 보드)

판정
띠 정답 기준 띠 = 측정기 바닥. 운영 판정 대상이 아니다(53 문서 2절)
25 문서 판정
띠
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
0–2% · 규약
규약 참고(53)
0–2%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 a 18.6% [16.9–20.5] 322/1,728
표본 250 운영 조건
자료 없음
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)))

출처

  • 47-decisions-1020.md 결정 6(링크별 정답 기준 예외 카드)
  • rules/type_fallback_ladder.py, gold_entity_name_match.py, paired_order_match.py, dataset_shape_match.py, params_key_diff_count.py
  • 39-g1-ladder.md, 40-policy-review.md 6절
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G0.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G1 유형

내용 오류 보류 6.77% [5.88–7.79] 질의

무엇

이름
유형
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
내용 오류
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
fit적합
broad_ok넓은 쪽으로 무난
unfit부적합결함내용 오류

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ④ 보조. 원문에 없는 구조를 지어내는 유형 금지(l1-system-v3:287–299, 48 문서 2절). 49종 경계가 자의적이라 여유
주 근거
① 규약 위반
53 목표(제안)
2–5%
53 달성
미달

무엇을 잡나

생성이 원문의 중심(수치, 관계, 순서, 문장)과 맞지 않는 유형을 골라, 없는 순서나 비교, 표를 지어내거나 원문의 표를 다른 것으로 바꾸거나, 원문 일부(하위 나열, 예시)만 담는 일을 잡는다. 유형이 틀리면 검색이 맞는 표현을 찾을 수 없어 기본 품질에 든다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 YAML 만 견주며, 넓은 유형으로 접은 것은 무난이고(l1v3-296) 정답 유형 사다리는 평가기 신뢰도를 재는 데만 쓴다(평가틀 47 결정 3). 항목을 어떻게 나눴는지는 G12, 형제 나눔은 G2 몫이다.

어떻게

질문

생성이 고른 유형(query_yaml L1 의 type)이 이 원문을 표현하기에 적합한가. 원문과 생성만 보고 판단한다.
- fit: 원문의 중심(수치인가, 관계인가, 순서인가, 문장인가)을 그 유형이 그대로 담는다.
- broad_ok: 원문에 또렷한 좁은 종이 없거나 좁은 종이 확실하지 않아 넓은 쪽 유형(entity 2개 이상이면 Enumeration.List, 1개면 TextBasedCommunication.LongFormTextLayout 이나 HighlightedMessage)으로 담았다. 내용이 남으므로 무난하다.
- unfit: 원문에 없는 순서, 계단, 비교, 표, 수치 축을 지어내는 유형이거나, 원문의 표를 표 아닌 것으로 바꿨거나, 원문의 중심과 무관한 유형이다.
- 유형이 원문 전체의 중심이 아니라 일부(하위 나열, 예시)만 담으면 unfit 이다.
- 49종 분류는 경계가 자의적이다. 「더 나은 유형이 있을 수 있다」 정도는 unfit 이 아니다. 그 유형이 원문의 중심을 담지 못하거나 왜곡할 때만 unfit 이다.
- 생성 컴포넌트가 여럿이면 하나라도 unfit 이면 unfit. L1 의 type 만 본다. 이름은 점과 밑줄만 다르다(ProcessFlow.Steps 와 ProcessFlow_Steps 는 같다).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 type_fallback_ladder
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.89
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.1: 라벨 없음. 묶음: 표를 표 아닌 유형 36%, 없던 순서 21%, 계층을 나열 21%

결과

6.77% [5.88–7.79]

182/2,687 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 라벨 없음. 묶음: 표를 표 아닌 유형 36%, 없던 순서 21%, 계층을 나열 21%
측정값 [95%]
6.77% [5.88–7.79] · 182/2,687 질의
보정값
—
판정
보류 표 몫은 공급 한계와 갈라야 함
신뢰도 표지
라벨 없음 · 반복 0.89
25 문서 판정
측정 중
쉬운 / 어려운 조건
6.4% / 7.8%
찾기 차이 / 확인 차이
+1.6 [-3.1–7.1] / +0.9 [-4.0–5.5]
목표(제안) · 근거
2–5% · 규약
규약 참고(53)
2–5%
도달 · 거리
(미달) · +1.77%p
정답 조건 값(표본 250 export)
조건 a 9.21% [7.9–10.7] 159/1,727
표본 250 운영 조건
5.96% [3.76–9.34] 17/285
답 분포(30c, 운영 조건 셀)
fit: 4,778(59.3%), broad_ok: 2,668(33.1%), unfit: 615(7.6%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

채택 연결
채택 검색 13.0% 대 비채택 16.2%, −3.3%p
출처
28 문서 요약 5

사례

G1 사례 결과 그림
결과

모델 답 부적합 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 LongFormTextLayout · 단위 b3d12d7af520574ddaf58a005626938b#0

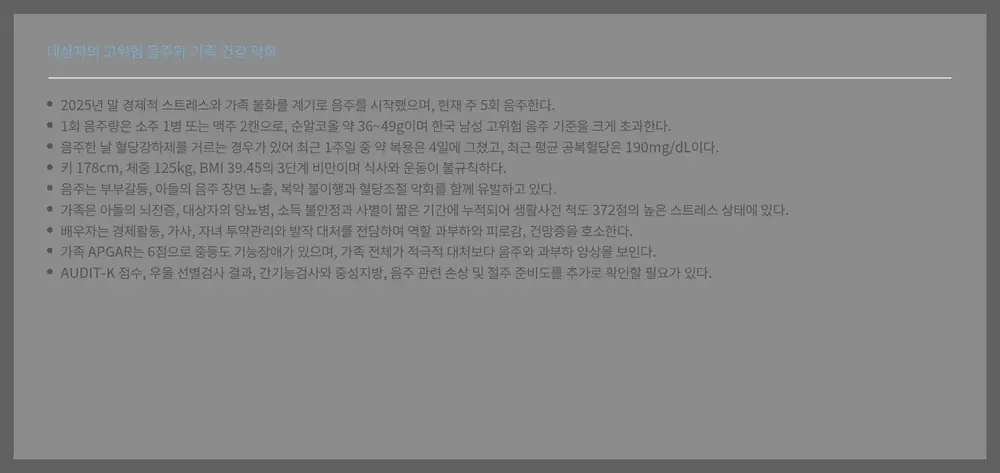
모델 근거(3회 중 첫 답): 원문의 중심은 가족영역별로 의미 있는 자료·결론·추가 자료를 행과 열로 정리한 표인데, 생성은 고위험 음주와 가족 건강 악화에 관한 일부 내용만 장문으로 담아 표의 구조와 전체 중심을 놓쳤다.

G1 사례 결과 그림
결과

모델 답 부적합 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 Transformation · 단위 bd3f6ea79f5286295d84f2125f2bf2ca#0

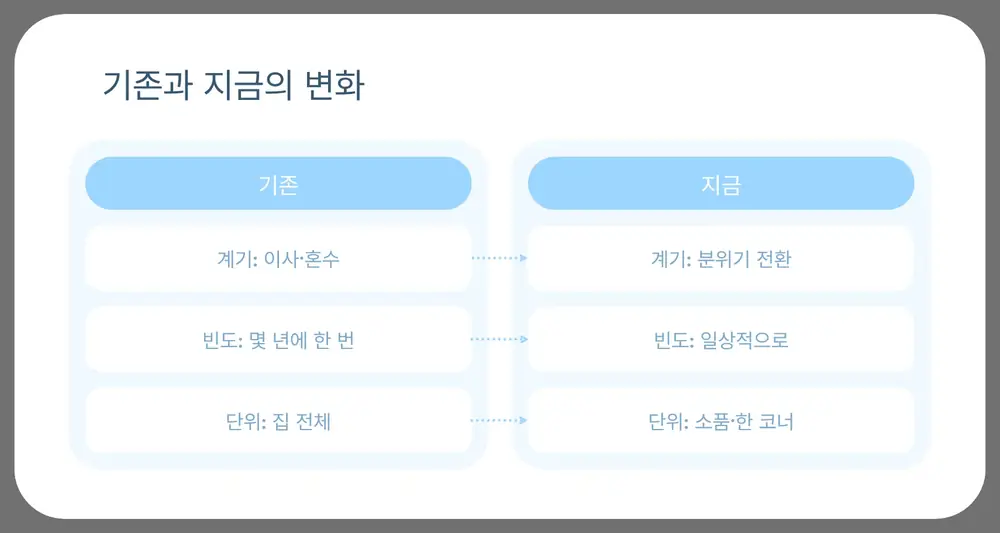
모델 근거(3회 중 첫 답): 원문은 기존과 지금을 열로 둔 행·열 표이며, Transformation 유형은 표를 그대로 보존하지 않는다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:28-32
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:287-299
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:22-25
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:296-299
  • spec/capability-table.md 3.0절(마지막 fallback 셋), 3.0.1절(행은 자기 것만), 3.2절(fallback 행)
  • tools/eval/rules/data/fallback_ladder.json
  • 17-generation-cards.md §7.1 G1
spec_refs(카드 yaml)
l1v3-22 · l1v3-287 · l1v3-296 · l1v3-321
spec_refs(manifest)
l1v3-22 · l1v3-287 · l1v3-296 · l1v3-321
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G2 L2 나눔

전달 저하 보류 8.51% [7.39–9.78] 질의

무엇

이름
L2 나눔
링크
생성
단위(셀)
질의
기본 m
기본 m 판정, 미달
등급
전달 저하
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
fit맞음
not_fit아님결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④ 덩어리 나눔은 판단이 갈린다
주 근거
④ 사람 한계
53 목표(제안)
3–5%
53 달성
미달

무엇을 잡나

원문에 읽는 방식이 다른 덩어리(목록 대 표, 자료 대 해석)가 있는데 생성이 그것을 한 형제로 합치거나, 한 덩어리를 둘로 쪼개거나, 형제의 읽는 방식을 틀리게 정하는 일을 잡는다. 형제 수는 입력의 큰 덩어리 수라는 것이 생성 규약이고(l2v3-97, l2v3-114), 잘못 나누면 검색 단위 자체가 틀린다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 L2 YAML 을 견준다. 같은 읽는 방식 안의 종 선택은 G1, 형제가 담은 글의 빠짐은 G7 몫이다.

어떻게

질문

원문이 읽는 방식이 다른 덩어리 둘로 되어 있는가? 생성 L2 가 나눈 형제 수와 유형이 그 덩어리에 맞는가?
덩어리 = 읽는 방식이 달라지는 큰 묶음(목록 대 표, 단계 대 비교, 자료 대 해석)이다. 제목 붙은 절이 여럿이어도 같은 종류를 같은 축으로 이어 가면 한 컴포넌트의 entity 들이다(l2v3-97).
여는 전제나 정의 한 줄과 닫는 총평은 형제 하나다(l2v3-114). 단, 뒤 목록 전체를 설명하거나 해석하는 독립 문장일 때만이다. 목록의 제목, 슬로건, 총계 행, 첫 항목이나 마지막 항목이 문장인 것, 항목에 딸린 메모, 두 줄짜리 짧은 원문의 둘째 줄은 전제나 총평이 아니다.
fit: 덩어리 수와 형제 수가 맞고 각 형제의 읽는 방식(목록, 표, 단계, 비교, 강조)이 그 덩어리에 맞는다. 원문이 덩어리 하나면 형제 하나가 맞다. 원문이 도구 지시문뿐이라 생성이 안내문 하나로 접은 것도 맞다.
not_fit: 읽는 방식이 다른 덩어리 둘을 한 형제로 합쳤거나, 같은 덩어리를 둘로 쪼갰거나, 형제의 읽는 방식이 덩어리와 다르다(표를 단계로, 비교를 목록으로).
따지지 않는 것: 같은 읽는 방식 안의 종 선택(HighlightedMessage 대 LongFormTextLayout, List 대 Steps)은 G1 몫이다. 형제가 담은 글의 빠짐은 G7 몫이다.
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
241 단위 · fable+gpt55 129 · fable-N(단독) 112
정답 대조 수 · 양성
241 · 양성 3
정밀도
0.17
재현율
0.67
F1
0.27
반복 일치(3회 최빈 비율)
0.94
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
133 쌍 · 답 97.0% · 결함 여부 97.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
합성 · 확정(합성)
보정 식(참고)
8.51% × 0.17 ÷ 0.67 = 2.13%

한계

  • 관문(25 문서 3절): 합성 정답으로 관문 통과(14 결정 2)
  • 30 문서 4.2: 정밀도 0.17, 보정 2.1%

결과

8.51% [7.39–9.78]

179/2,104 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 정밀도 0.17, 보정 2.1%
측정값 [95%]
8.51% [7.39–9.78] · 179/2,104 질의
보정값
2.1%
판정
보류
신뢰도 표지
라벨 241 · 정밀도 0.17 · 반복 0.94
25 문서 판정
확정(합성)
쉬운 / 어려운 조건
4.7% / 16.9%
찾기 차이 / 확인 차이
+15.1 [8.1–23.6] / +8.5 [3.7–14.4]
목표(제안) · 근거
4.69–5.90% · 쉬운 조건(G-a)
규약 참고(53)
3–5%
도달 · 거리
미달 · +2.61%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
6.53% [4.1–10.3] 16/245
답 분포(30c, 운영 조건 셀)
fit: 9,401(89.4%), not_fit: 1,119(10.6%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-a L2 컴포넌트 하나 대 L2 컴포넌트 둘 이상4.69% 68/1,45016.9% 106/628나눌 자리를 정하지 않아도 된다(05 문서 1.1). L2 하나면 「나눌 것을 안 나눔」만 남는다

채택 연결

자료 없음

사례

G2 사례 결과 그림
결과

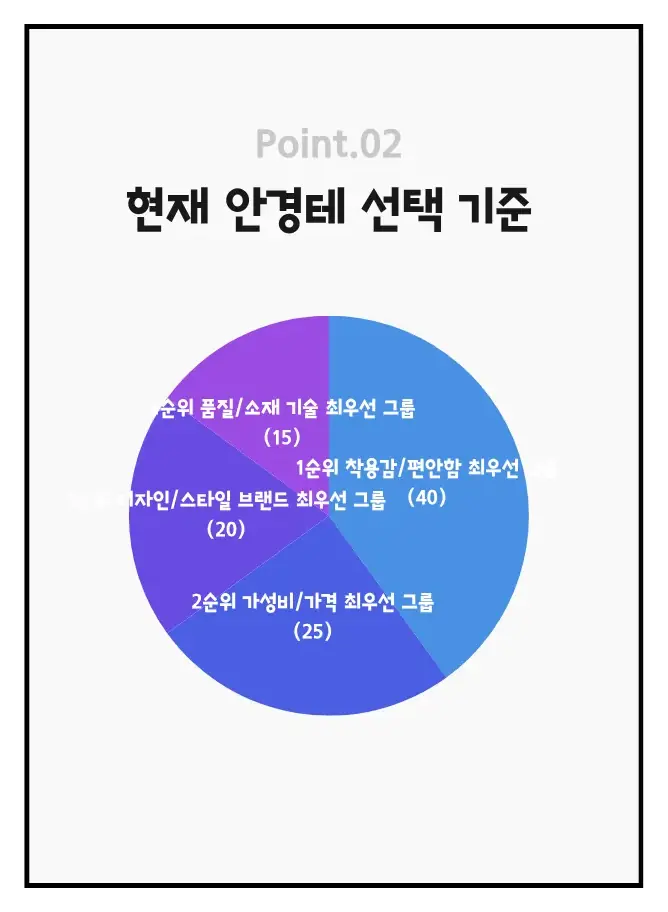
모델 답 아님 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 PieChart · 단위 acdc01f2e97cc5f213d64060c29c7bd8#1

모델 근거(5회 중 첫 답): 독립적인 마무리 인사이트 ‘착용감(Fit)은 입장권, 디자인은 선택권’을 과거 항목과 같은 목록 형제에 접었다.

G2 사례 결과 그림
결과

모델 답 아님 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 2d6918ee402b05b3d9f36ceb5a831f1e#2

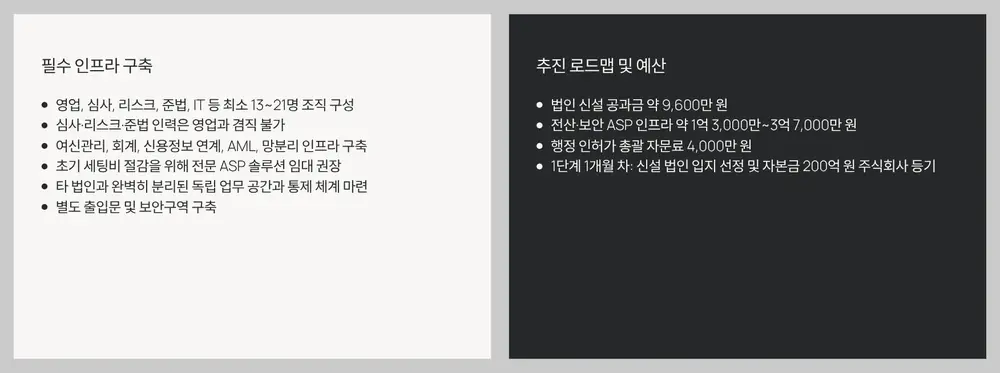
모델 근거(5회 중 첫 답): 슬라이드 8의 인프라 요건은 표로 읽는 덩어리인데, 목록 컴포넌트에 다른 내용과 함께 합쳐져 있다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l2-system-v3.txt:26-27
  • rust/comp-pass/crates/comp-pass-logic/prompts/l2-system-v3.txt:97-118
  • 17-generation-cards.md §7.1 G2
spec_refs(카드 yaml)
l2v3-26 · l2v3-97 · l2v3-114
spec_refs(manifest)
l2v3-26 · l2v3-97 · l2v3-114
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G3 항목 누락

내용 오류 보류 4.04% [3.33–4.88] 질의

무엇

이름
항목 누락
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
내용 오류
카드 상태
status light · tier measuring

결함 답과 등급

개수 답(원문 항목 가운데 생성에 없는 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 항목 전량 요구(l1-system-v3:41–68)
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

원문이 나란히 늘어놓은 항목(단계, 범주, 비교 대상, 표의 행 이름)이 생성 YAML 에서 통째로 빠지는 일을 잡는다. 원문 항목을 빠짐없이 질의로 옮기는 것은 생성 프롬프트가 요구하는 책임이다(l1-system-v3:41–68, 기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 YAML 만 견주며, 줄인 이름과 문서 제목, items, dataset 으로 옮겨 간 이름은 있는 것으로, 안내문과 자리표시 글은 세지 않는다(평가틀 40 Q3, Q4). G3 은 항목 수의 누락, G7 은 글의 누락이고, G12 가 wrong_axis 면 G3 의 누락 수는 해석하지 않는다(기본품질 20).

어떻게

질문

원문이 말하는 항목(entity) 가운데 생성(query_yaml)에 없는 것이 몇 개인가. 원문만 기준으로 센다.
- 항목 = 원문이 나란히 늘어놓은 단위(단계, 범주, 비교 대상, 표의 행 이름 등). 항목에 딸린 설명 문장은 항목이 아니다(글 누락은 G7 몫).
- 있는 것으로 본다: 이름을 줄여 쓴 것, 생성의 다른 필드(문서 제목, items, dataset 의 행이나 칸, period)로 옮겨 간 것, 하위 항목을 items 한 줄 문자열로 편 것.
- 세지 않는다: 템플릿 안내문과 자리표시 글(ENTER TEXT, 내용 입력, 이곳에 …을 입력해 주세요, 항목 01 처럼 내용이 아닌 글), 도구에 시키는 말(색, 글꼴, 분량).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 gold_entity_name_match
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 2,000 정답 없음. 250 판 F1 0.34, 양성 71
  • 30 문서 4.1: 라벨 없음, 반복 일치 0.67(갈림 80%). 묶음: 「있는데 없다고 적음」 20%

결과

4.04% [3.33–4.88]

101/2,502 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 라벨 없음, 반복 일치 0.67(갈림 80%). 묶음: 「있는데 없다고 적음」 20%
측정값 [95%]
4.04% [3.33–4.88] · 101/2,502 질의
보정값
불명
판정
보류 (측정 흔들림)
신뢰도 표지
라벨 없음 · 반복 0.98
25 문서 판정
측정 중
쉬운 / 어려운 조건
2.4% / 8.4%
찾기 차이 / 확인 차이
+5.7 [-0.8–12.6] / +6.2 [1.2–12.1]
목표(제안) · 근거
2.44–3.24% · 쉬운 조건(잠정)(G-a)
규약 참고(53)
2–3%
도달 · 거리
(미달) · +0.80%p
정답 조건 값(표본 250 export)
조건 a 1.80% [1.27–2.54] 31/1,727
표본 250 운영 조건
4.91% [2.95–8.08] 14/285
답 분포(30c, 운영 조건 셀)
0: 11,980(95.8%), 1: 246(2.0%), 2: 107(0.9%), 3: 56(0.4%), 4: 39(0.3%), 5: 23(0.2%), 6: 21(0.2%), 7: 10(0.1%), 9: 7(0.1%), 10: 4(0.0%), 11: 3(0.0%), 12: 3(0.0%), 16: 3(0.0%), 18: 1(0.0%), 19: 7(0.1%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-a L2 컴포넌트 하나 대 L2 컴포넌트 둘 이상2.44% 45/1,8478.44% 53/628항목을 컴포넌트 사이에 나누다 빠뜨릴 자리가 없다(제안)

채택 연결

자료 없음

사례

G3 사례 결과 그림
결과

모델 답 3 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 LongFormTextLayout · 단위 3bddb19083974ff819f93505e1beeccb#0

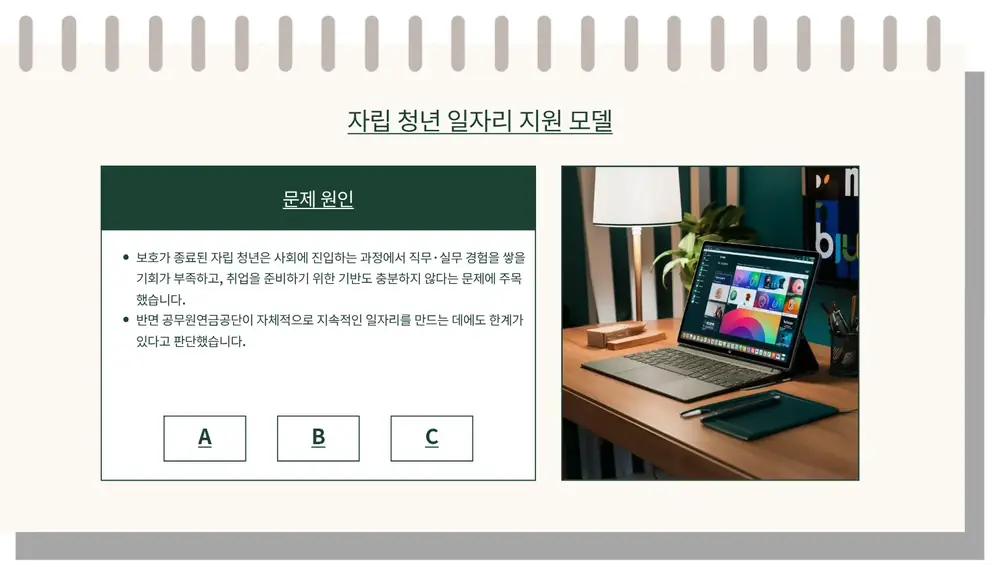
모델 근거(5회 중 첫 답): 원문의 나열 항목 중 ‘역량 진단’, ‘벤치마킹’, ‘실행 프로세스 설계’가 생성에 없습니다.

G3 사례 결과 그림
결과

모델 답 1 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 HighlightedMessage · 단위 49d2384f47c24c91c1f34f6553a9108a#1

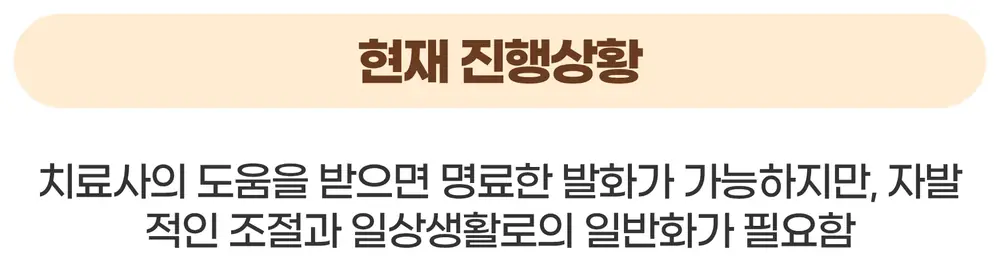
모델 근거(5회 중 첫 답): ‘현재 진행상황’은 원문의 별도 항목이고 생성에는 그 이름이 없습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:41-68
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:320-324
  • 17-generation-cards.md §2 G-S5(entity 수 차, 옛 1.3)
spec_refs(카드 yaml)
l1v3-174 · l1v3-213 · l1v3-281
spec_refs(manifest)
l1v3-174 · l1v3-213 · l1v3-281
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G4 항목 순서

전달 저하 준수 근처 4.88% [4.10–5.79] 질의

무엇

이름
항목 순서
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
kept지킴
broken어김결함전달 저하
no_order순서 뜻 없음

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 원문 순서 유지(l1-system-v3:41–68)
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

원문의 항목 순서에 뜻이 있는데 생성이 그 순서를 섞는 일을 잡는다. 원문 순서 보존은 생성 프롬프트가 요구하는 책임이다(l1-system-v3:41–68, 기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 YAML 을 견주며, 순서에 뜻이 없는 나열을 바꾼 것은 결함이 아니다. 대치 결과에서 순서가 뒤바뀌어 읽히는 것은 E5 몫이다.

어떻게

질문

생성의 항목 순서가 원문의 순서를 지켰는가. 원문과 생성만 보고 판단한다.
- kept: 생성의 항목이 원문에 나온 순서대로다. 빠진 항목은 건너뛰고 남은 것끼리 본다.
- broken: 원문의 순서와 다르게 섞였다.
- no_order: 원문의 항목 순서에 뜻이 없거나(바꿔 늘어놓아도 뜻이 같은 나열), 원문과 짝지을 수 있는 항목이 둘 미만이다.
- 원문에 순서 뜻이 없는데 생성이 순서를 바꾼 것은 결함이 아니다(no_order).
입력 자료
source_text query_yaml
측정기
LLM
정답 종류
rule · 규칙 paired_order_match
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.92
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 2,000 정답 없음. 250 판 F1 0.00, 양성 5
  • 30 문서 4.2: 라벨 적음

결과

4.88% [4.10–5.79]

122/2,502 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 라벨 적음
측정값 [95%]
4.88% [4.10–5.79] · 122/2,502 질의
보정값
—
판정
준수 근처
신뢰도 표지
라벨 없음 · 반복 0.92
25 문서 판정
측정 중
쉬운 / 어려운 조건
2.1% / 13.2%
찾기 차이 / 확인 차이
+10.7 [5.1–18.3] / +11.9 [4.7–20.3]
목표(제안) · 근거
2.06–2.81% · 쉬운 조건(G-a)
규약 참고(53)
2–3%
도달 · 거리
(미달) · +2.07%p
정답 조건 값(표본 250 export)
조건 a 0.75% [0.44–1.28] 13/1,727
표본 250 운영 조건
4.56% [2.68–7.65] 13/285
답 분포(30c, 운영 조건 셀)
kept: 9,367(74.9%), broken: 636(5.1%), no_order: 2,507(20.0%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-a L2 컴포넌트 하나 대 L2 컴포넌트 둘 이상2.06% 38/1,84713.2% 83/628나눈 뒤 원문 순서를 컴포넌트마다 다시 맞출 일이 없다(제안)
G-b 글머리 없음, 1개 대 글머리 2개 이상2.33% 35/1,5008.77% 86/981글머리 원문은 항목이 많아 순서를 어길 기회가 많다(제안, 23 문서 2.1 의 G-b 역방향과 같음)

채택 연결

자료 없음

사례

G4 사례 결과 그림
결과

모델 답 어김 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 b0088a6574c55960d441172cf134e96a#3

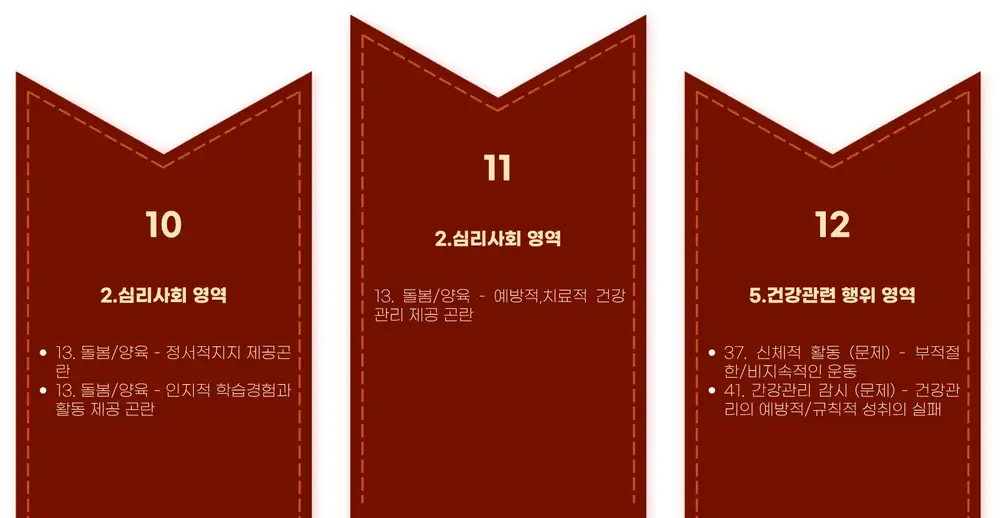
모델 근거(5회 중 첫 답): 심리사회 영역의 첫 항목들 뒤에 원문에서 뒤에 나온 지역사회자원·역할변화 항목이 배치되어, 원문 순서와 다르게 섞였다.

G4 사례 결과 그림
결과

모델 답 어김 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 918ef6b6a66d0066af3fdd720feaf8fd#0

모델 근거(5회 중 첫 답): 셋째 항목에서 원문의 ESD 초점 변화가 능력 있는 유아상보다 먼저 나오고 사례가 변혁적 교육 방향보다 먼저 나오지만, 생성은 이를 뒤바꿨다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:41-68
  • 17-generation-cards.md §2 G-S5(순서 뒤집힘, 옛 1.6)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G5 dataset 모양

내용 오류 보류 12.8% [9.6–16.9] 질의

무엇

이름
dataset 모양
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
내용 오류
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
kept지킴
broken어김결함내용 오류
no_table원문에 표 없음

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 표 모양 유지(l1-system-v3:320–324)
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

원문의 표를 생성 dataset 이 전치하거나, 행이나 열을 빼거나 합치거나 새로 세워 칸 글이 달라지는 일을 잡는다. 입력이 표면 그 행과 열을 그대로 옮기는 것이 생성 규약이고(l1v3-321), 그래야 표, 차트 검색과 칸 대치가 성립한다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 dataset 을 견주며, 머리글을 붙이거나 첫 행을 본문으로 내렸어도 칸 글이 모두 같으면 같다(평가틀 40 Q5). 색인의 칸 지도는 P4, 대치 결과의 칸 값은 D7 몫이다.

어떻게

질문

원문에 표(행과 열)가 있을 때 생성 dataset 이 그 구조를 지켰는가. 원문과 생성만 보고 판단한다.
- kept: 원문 표의 행과 열이 생성 dataset 에 그대로 있다. 생성이 머리글을 지어 붙이거나 첫 행을 본문으로 내리는 등 정리했어도 칸 글이 모두 같으면 kept 다.
- broken: 행과 열이 바뀌었거나(전치), 행이나 열을 빼거나 합치거나 새로 세워 칸 글이 원문과 달라졌다.
- no_table: 원문에 행과 열로 된 표가 없다.
- 칸 글을 줄여 쓰거나 단위 표기를 머리글로 올린 것은 같은 칸 글로 본다.
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 dataset_shape_match
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.95
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 2,000 정답 없음. 250 판 F1 0.54, 양성 46
  • 30 문서 4.1: 라벨 없음, 표 질의 320

결과

12.8% [9.6–16.9]

41/320 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 라벨 없음, 표 질의 320
측정값 [95%]
12.8% [9.6–16.9] · 41/320 질의
보정값
—
판정
보류
신뢰도 표지
라벨 없음 · 반복 0.95
25 문서 판정
측정 중
쉬운 / 어려운 조건
11.1% / 19.4%
찾기 차이 / 확인 차이
+7.2 [-9.3–28.8] / +9.7 [-11.2–36.5]
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
(미달) · +9.81%p
정답 조건 값(표본 250 export)
조건 a 8.31% [5.9–11.6] 31/373
표본 250 운영 조건
12.5% [5.5–26.1] 5/40
답 분포(30c, 운영 조건 셀)
kept: 870(54.4%), broken: 206(12.9%), no_table: 524(32.8%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

G5 사례 결과 그림
결과

모델 답 어김 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 ListingTable · 단위 b0a1d55d8835e2fa1fb7f6a2badd95b2#0

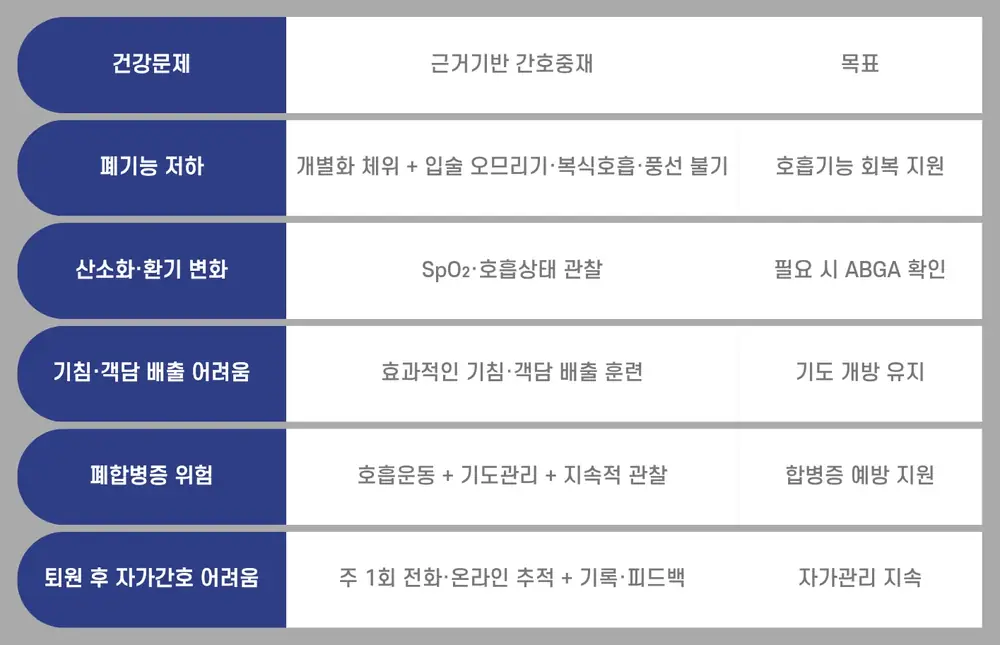
모델 근거(5회 중 첫 답): 원문의 ‘SpO₂·호흡상태 관찰, 필요 시 ABGA 확인’은 한 칸인데 생성에서는 쉼표로 나뉘어 행의 열 구조가 달라진다.

G5 사례 결과 그림
결과

모델 답 어김 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 ListingTable · 단위 0ea50bd6b2d59d897851e1fce2b9be13#0

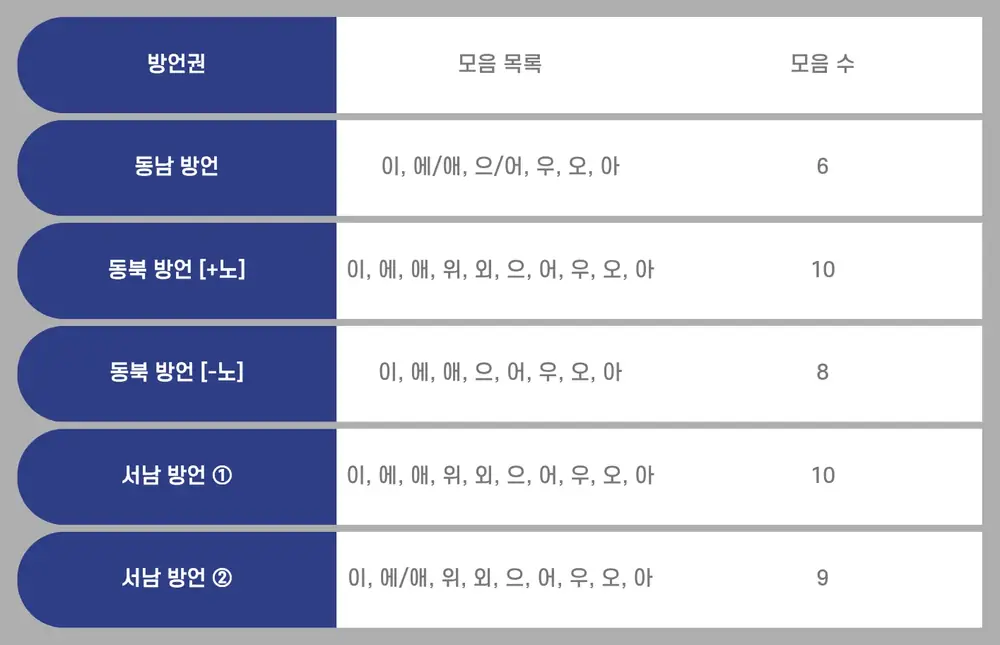
모델 근거(5회 중 첫 답): 원문은 모음 목록과 괄호 속 수가 한 칸인데, 생성은 수를 별도 ‘모음 수’ 열로 분리해 열 구조를 바꿨다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:41-68
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:320-324
  • 17-generation-cards.md §2 G-S5(dataset 행과 열 수, 축 방향)
spec_refs(카드 yaml)
l1v3-273 · l1v3-281 · l1v3-321
spec_refs(manifest)
l1v3-273 · l1v3-281 · l1v3-321
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G5.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G6 params

보류 운영 조건 값 없음

무엇

이름
params
링크
생성
단위(셀)
질의
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

개수 답(원문에 맞지 않는 params 키 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① params 값 보존(l1-system-v3:83–87)
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
달성

무엇을 잡나

생성이 원문에 없는 강조 대상, 기준선, 목표값을 params 로 지어내거나, 원문이 정한 정렬(내림차순, 시간 순)을 어기는 일을 잡는다. params 는 표현 방식만 정하는 값이고 쓸 값이 없으면 생략한다는 것이 생성 규약이며(l1v3-83), 지어낸 값은 검색 순위를 흔든다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 params 를 견주며, 생략은 규약이 허용하므로 세지 않고 정의 밖 이름 같은 형식 문제는 검증기 몫이다. 색인 params 는 P5 몫이다.

어떻게

질문

생성 params(query_yaml 각 컴포넌트의 params)의 값 가운데 원문에 맞지 않는 키가 몇 개인가. 원문과 생성만 보고 판단한다.
- 센다: 원문에 없는 내용을 params 로 지어낸 키(원문에 없는 강조 대상, 기준선, 목표값, 단위), 원문이 정한 것을 어긴 키(원문이 내림차순인데 오름차순, 원문이 시간 순인데 다른 정렬 등).
- 세지 않는다: params 를 생략한 것(규약이 허용한다), 원문이 직접 말하지 않는 표현 선택(방향, 모양 등)으로서 원문과 어긋나지 않는 값, 정의 밖 이름이나 허용 밖 값 같은 형식 문제(검증기 몫).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 params_key_diff_count
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 2,000 생성 카드 run(x21e)에 없다. 표본 250 밖 1,750 원문 값은 x21a-gen-G6
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 2,000 생성 카드 run(x21e)에 없다. 표본 250 밖 1,750 원문 값은 x21a-gen-G6
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 2,000 생성 카드 run(x21e)에 없다. 표본 250 밖 1,750 원문 값은 x21a-gen-G6)
53 문서 근거
① 규약 위반 · 53 목표(제안) 0–1%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
0–1% · 규약
규약 참고(53)
0–1%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 a 0.00% [0.00–0.22] 0/1,727
표본 250 운영 조건
0.00% [0.00–1.33] 0/285
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(2,000 생성 카드 run(x21e)에 없다. 표본 250 밖 1,750 원문 값은 x21a-gen-G6))

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:83-87
  • src/lib/visual-summary/iis/propertyVocabulary.ts PROPERTY_PARAM_SPEC
  • 17-generation-cards.md §7.1 G6(v6 + v4 세트)
spec_refs(카드 yaml)
l1v3-83 · param-spec
spec_refs(manifest)
l1v3-83 · param-spec
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G6.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
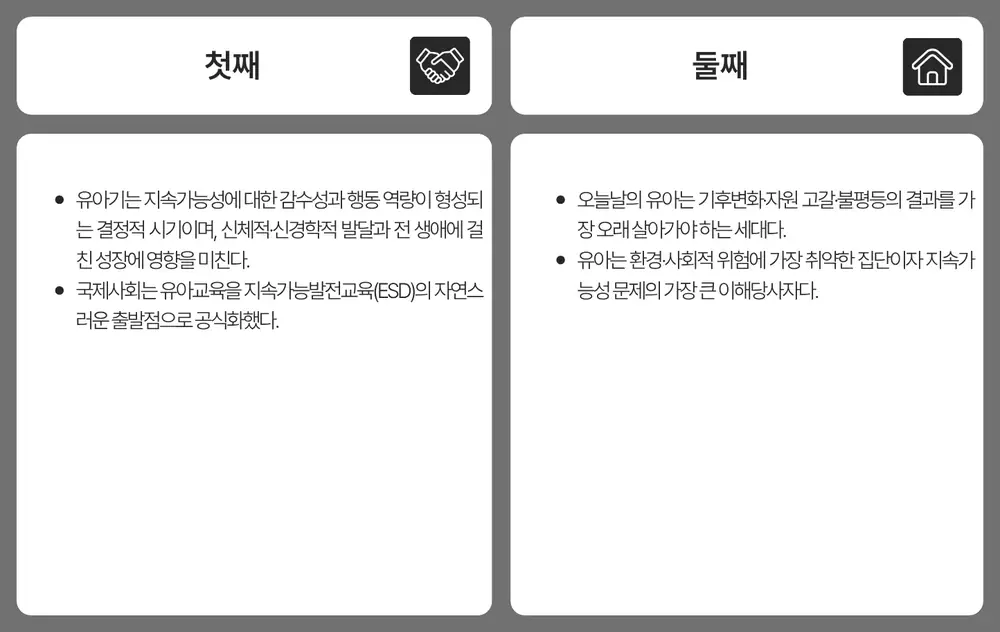
생성 · 질의 단위 · 기본 m

G7 글 누락

전달 저하 미준수 14.5% [13.2–16.0] 질의

무엇

이름
글 누락
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

개수 답(사라진 글 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 뜻 보존(l1-system-v3:174–175, 213–218)
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

원문의 내용 글(항목 이름, 설명 문장, 수치, 표 칸)이 생성 YAML 에서 뜻째로 사라지는 일을 잡는다. 원문 뜻을 질의에 남기는 것은 「원문을 시각화한다」는 VS 개념의 첫 조건이다(기본품질 13 1.1, l1v3-174). 생성 링크의 책임이고 원문과 생성 L1 YAML 을 견주며, 줄여 쓴 것과 다른 필드로 옮긴 것은 있는 것으로, 안내문과 도구 지시는 세지 않는다(평가틀 40 Q3, Q4, l1v3-213). G3 은 항목 수의 누락, G7 은 글의 누락이다.

어떻게

질문

원문의 내용 글(항목 이름, 설명 문장, 수치, 표의 칸) 가운데 생성(query_yaml L1)에서 뜻이 사라진 것이 몇 개인가. 원문과 생성만 보고 판단한다.
- 사라지지 않은 것으로 본다: 줄여 쓴 것, 생성 문서 어디에(문서 제목, 항목, 설명, items, dataset 의 행이나 칸, period) 그 뜻의 글이 있는 것. 원문의 항목 이름이나 머리말이 생성의 문서 제목으로 옮겨 간 것도 있는 것이다.
- 세지 않는다: 템플릿 안내문과 자리표시 글(ENTER TEXT, 내용 입력, 이곳에 …을 입력해 주세요, 항목 01 처럼 내용이 아닌 글), 도구에 시키는 말(색, 글꼴, 분량, 만들어 줘).
- 한 덩어리(한 문장, 한 칸)를 하나로 센다. 항목 이름 자체가 사라진 것도 센다(G3 와 함께 잡힌다).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 g7_gold_compare_ref
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
자료 없음
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.94
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 2,000 정답 없음. 250 판 F1 0.65, 양성 68
  • 30 문서 4.2: 정답 YAML 조건 3.9%

결과

14.5% [13.2–16.0]

364/2,502 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
정답 조건 정답 YAML 조건 3.9%
측정값 [95%]
14.5% [13.2–16.0] · 364/2,502 질의
보정값
—
판정
미준수
신뢰도 표지
라벨 없음 · 반복 0.94
25 문서 판정
측정 중
쉬운 / 어려운 조건
7.7% / 33.9%
찾기 차이 / 확인 차이
+23.9 [14.1–33.2] / +28.5 [20.2–37.6]
목표(제안) · 근거
7.74–9.05% · 쉬운 조건(G-a)
규약 참고(53)
2–3%
도달 · 거리
(미달) · +5.50%p
정답 조건 값(표본 250 export)
조건 a 3.94% [3.12–4.96] 68/1,727
표본 250 운영 조건
10.5% [7.2–15.0] 25/238
답 분포(30c, 운영 조건 셀)
0: 10,667(85.3%), 1: 998(8.0%), 2: 365(2.9%), 3: 126(1.0%), 4: 97(0.8%), 5: 56(0.4%), 6: 64(0.5%), 7: 17(0.1%), 8: 14(0.1%), 9: 11(0.1%), 10: 18(0.1%), 11: 2(0.0%), 12: 8(0.1%), 13: 3(0.0%), 14: 8(0.1%), 15: 5(0.0%), 19: 5(0.0%), 21: 3(0.0%), 22: 7(0.1%), 28: 4(0.0%), 31: 3(0.0%), 33: 3(0.0%), 34: 4(0.0%), 36: 4(0.0%), 38: 3(0.0%), 40: 4(0.0%), 43: 3(0.0%), 63: 4(0.0%), 96: 1(0.0%), 100: 1(0.0%), 117: 1(0.0%), 122: 1(0.0%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-a L2 컴포넌트 하나 대 L2 컴포넌트 둘 이상7.74% 143/1,84733.9% 213/628덩어리가 여럿이면 덩어리 사이 설명 문장이 어느 컴포넌트에도 안 실린다(제안, 15 문서 G7 「설명 맥락 축약」)
G-b 글머리 없음, 1개 대 글머리 2개 이상9.47% 142/1,50022.0% 216/981항목 아래 딸린 설명과 머리글이 많아 줄일 때 사라진다(제안)

채택 연결

자료 없음

사례

G7 사례 결과 그림
결과

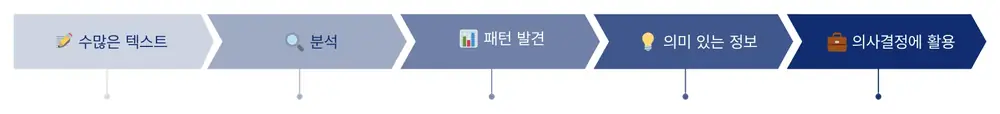
모델 답 1 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 Steps · 단위 d4c7c9e1b811002ede83bff178b5fb30#0

모델 근거(5회 중 첫 답): ‘그래서 텍스트마이닝이란?’은 생성에 없고, 흐름도 문구와 마지막 설명 문장은 있습니다.

G7 사례 결과 그림
결과

모델 답 2 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 c3d21e23e53891d10593ded880b4c195#0

모델 근거(5회 중 첫 답): ‘내용’과 ‘평가 내용’ 항목명이 생성에 없습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:174-175
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:213-218
  • 17-generation-cards.md §7.1 G7
  • 47-decisions-1020.md 원칙과 결정 3, 54-index-g7-operating.md
  • 신뢰도 정답 g7_gold_compare_ref = G7 v3(정답 YAML 대 생성) 판정의 최빈 답(eval/ref/g7_gold_ref.json)
spec_refs(카드 yaml)
l1v3-174 · l1v3-213
spec_refs(manifest)
l1v3-174 · l1v3-213
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G7.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G8 지어냄

내용 오류 준수 3.28% [2.65–4.05] 질의

무엇

이름
지어냄
링크
생성
단위(셀)
질의
기본 m
기본 m 판정, 미달
등급
내용 오류
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
yes있음결함내용 오류
no없음

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 원문에 없는 사실 금지(l1-system-v3:174–175)
주 근거
① 규약 위반
53 목표(제안)
0–2%
53 달성
달성

무엇을 잡나

생성 글에 원문 어디에도 없는 사실, 이름, 수치, 평가, 인과 주장이 새로 들어가는 일을 잡는다. 값은 인용이라 입력에 없는 낱말을 만들지 않는 것이 생성 규약이고(l1v3-174), 원문 시각화라는 VS 개념의 전제다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 글을 견주며, label 이나 표 머리글 같은 형식 표지와 원문 수로 계산한 수는 지어냄이 아니다(G8 v2, v3). 수와 단위는 G9 가 규칙으로 따로 센다.

어떻게

질문

생성 글(query_yaml 의 값)에 원문 어디에도 없는 내용(사실, 이름, 수치, 평가나 인과 주장)이 새로 들어 있는가?
yes: 원문에 없는 사실, 인명, 기관명, 수치, 평가 문장, 인과 주장이 생성 글에 있다.
no: 그 밖. 원문을 줄여 쓴 것, 형식 표지, 제목은 세지 않는다.
지어냄이 아닌 것(이것만 있으면 no): 원문에서 파생된 것은 원문에 글자 그대로 없어도 지어냄이 아니다.
- 형식 표지: entity 의 label, 묶음 이름, 표 머리글처럼 원문 내용에 이름을 붙인 것. value 없이 label 한 줄만 있는 항목도 같다(예: 「회원권 요금」, 「Living arrangements」, 「항목별 응답 현황」, 「핵심 정리」, 「Overview」).
- 원문 수치의 파생: 원문에 있는 수를 더한 합계, 차이, 비율, 단위 환산(예: 원문 「A 120명, B 85명」에 「합계 205」, 원문 「매출 3,400」「비용 1,200」에 「Total 4,600」). 원문 수로 계산되는 수는 새 수치가 아니다(G9 몫).
- 원문의 관계를 풀어쓴 관계 설명이나 문장 재구성(새 사실이 생긴 것만 센다). 원문이 도구 지시문뿐일 때 생성이 내는 안내 문구(「요약할 내용 없음」). 항목이 다른 항목 아래 배치돼 소속이 달리 보이는 것(배치 몫).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v3

신뢰도

정답 종류
human
모델 라벨(사람 대신)
284 단위 · fable+gpt55 149 · fable-N(단독) 135
정답 대조 수 · 양성
284 · 양성 0
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 99.3% · 결함 여부 99.3%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
합성 · 확정(합성)

한계

  • 관문(25 문서 3절): 합성 정답으로 관문 통과(14 결정 2)
  • 30 문서 4.1: 라벨 284 에서 양성 0, 정밀도 0. 근거 묶음에 「인과, 평가 덧붙임」이 있으나 반복 갈림 62%

결과

3.28% [2.65–4.05]

82/2,502 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 라벨 284 에서 양성 0, 정밀도 0. 근거 묶음에 「인과, 평가 덧붙임」이 있으나 반복 갈림 62%
측정값 [95%]
3.28% [2.65–4.05] · 82/2,502 질의
보정값
바닥
판정
준수
신뢰도 표지
라벨 284 · 양성 0 · 반복 0.98
25 문서 판정
확정(합성)
쉬운 / 어려운 조건
2.4% / 5.9%
찾기 차이 / 확인 차이
+3.8 [-1.3–10.4] / +2.9 [-0.8–6.8]
목표(제안) · 근거
0–2% · 규약
규약 참고(53)
0–2%
도달 · 거리
미달 · +1.28%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
1.75% [0.75–4.04] 5/285
답 분포(30c, 운영 조건 셀)
yes: 480(3.8%), no: 12,030(96.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-g5 생성 유형 2.5 텍스트와 사람 대 생성 유형 2.5 텍스트와 사람 밖0.76% 3/3933.79% 79/2,085텍스트 종은 원문 문장을 그대로 담아 관계를 새로 쓸 자리가 없다(capability-table 2.5, 제안 해석)

채택 연결

자료 없음

사례

G8 사례 결과 그림
결과

모델 답 있음 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 ListingTable · 단위 3d7d66ea088aaeaa8debc7a80bcf94c6#0

모델 근거(5회 중 첫 답): 원문은 두 이름만 함께 제시하지만, 생성 글은 각 이름을 특정 취업 유형과 연결해 원문에 없는 관계를 추가했다.

G8 사례 결과 그림
결과

모델 답 있음 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 Steps · 단위 7b677dabd967a35940f80eaabb1dd787#0

모델 근거(5회 중 첫 답): L1은 무대를 실제로 준비하고 필요한 역할을 정했다고 덧붙였으며, 원문에는 무대가 필요하다고 생각하고 역할놀이로 이어졌다고만 되어 있습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:174-175
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:213-218
  • 17-generation-cards.md §7.1 G8
spec_refs(카드 yaml)
l1v3-174 · l1v3-213
spec_refs(manifest)
l1v3-174 · l1v3-213
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G8.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G9 수와 단위

내용 오류 준수 3.47% [2.84–4.23] 질의

무엇

이름
수와 단위
링크
생성
단위(셀)
질의
기본 m
기본 m 판정, 미달
등급
내용 오류
카드 상태
status light · tier confirmed

결함 답과 등급

개수 답(원문에 없는 수 또는 단위 개수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 원문 수 보존(l1-system-v3:238–240)
주 근거
① 규약 위반
53 목표(제안)
0–2%
53 달성
미달

무엇을 잡나

생성 글에 원문에 없는 수(계산해 넣은 차, 비율, 요청하지 않은 합계, 자릿수가 바뀐 수)나 원문에 없는 단위가 들어가는 일을 잡는다. 입력에 적힌 수만 적고 없는 단위를 붙이지 않는 것이 생성 규약이고(l1v3-168, l1v3-238), 원문에 없는 수는 결과 그림에서 사실 오류로 보인다(기본품질 13 1.1). 생성 링크의 책임이고 원문과 생성 글을 규칙으로 견주며, 한자 수 단위의 환산과 원문이 요청한 합계는 결함이 아니다(기본품질 14 Q11, Q12). G8 의 수치 판이다.

어떻게

질문

생성 글에 원문에 없는 수나 단위가 있는가. 서로 다른 수나 단위 표기마다 1 로 세어 합을 낸다.
- 생성 글 = query_yaml 의 title, entity 의 label, items, value 와 unit, dataset 의 머리글과 칸. L1 과 L2 를 다 본다.
- 수 = 숫자 덩어리. 천 단위 쉼표와 소수점 뒤 0 은 무시한다(25.0 과 25 는 같은 수, 1,550 과 1550 도 같다). 단위 = 수 바로 뒤에 붙은 단위 표기(%, 원, 명, 년, 개월, kg 등).
- 세는 것: (1) 원문 어디에도 없는 수. 차, 비율, 평균처럼 계산해 넣은 수, 원문이 요청하지 않은 합계, 자릿수를 바꿔 값이 달라진 수(원문 1,550 을 155 로)가 여기 든다. (2) 원문 어디에도 없는 단위 표기.
- 세지 않는 것: 원문에 있는 단위를 다른 수에 붙인 것(원문에 2019년이 있으면 2020 에 년을 붙여도 아니다), 항목 번호와 순번과 「4-1」 같은 형식 표지, 원문의 수를 빼거나 줄여 쓴 것(누락은 G7 몫), 조사와 띄어쓰기 차이(「27,155명에서」와 「27,155명 에서」는 같다), 표 번호와 조항 번호의 생략, 날짜와 시간 표기의 형식 차이, 한자 수 단위를 숫자로 환산한 같은 값(「3만」을 「30000」으로, 머리글이 「억」일 때 「4억4천」을 4.4 로), 원문이 합계를 요청했을 때(「합계」, 「총계」, 「합산」 등) 같은 행이나 열의 수를 더해 넣은 합계.
입력 자료
source_text query_yaml spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 number_unit_exact_token
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
자료 없음
카드 버전
v5

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
199 · 양성 6 (규칙 대조)
정밀도
1.00
재현율
0.17
F1
0.29
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
0.97 (199 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
3.47% × 1.00 ÷ 0.17 = 20.8%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.1: 정밀도 1.0, 재현율 0.17(라벨 양성 6). 반복 일치 0.99

결과

3.47% [2.84–4.23]

93/2,683 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 정밀도 1.0, 재현율 0.17(라벨 양성 6). 반복 일치 0.99
측정값 [95%]
3.47% [2.84–4.23] · 93/2,683 질의
보정값
2.7–3.5%
판정
준수 (규칙값, 라벨 표본 적음)
신뢰도 표지
규칙 대조 199 · 정밀도 1.00 · 반복 0.98
25 문서 판정
확정
쉬운 / 어려운 조건
2.1% / 7.8%
찾기 차이 / 확인 차이
+9.0 [2.8–16.7] / +1.8 [-1.8–7.3]
목표(제안) · 근거
2.08–2.80% · 쉬운 조건(잠정)(G-a)
규약 참고(53)
0–2%
도달 · 거리
미달 · +0.67%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
2.81% [1.43–5.44] 8/285
답 분포(30c, 운영 조건 셀)
0: 591(98.5%), 1: 5(0.8%), 2: 3(0.5%), 4: 1(0.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-g5 생성 유형 2.5 텍스트와 사람 대 생성 유형 2.5 텍스트와 사람 밖0.51% 2/3933.97% 91/2,290텍스트 종은 수와 단위를 따로 필드로 세우지 않는다(제안)

채택 연결

자료 없음

사례

G9 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 LongFormTextLayout · 단위 b3d12d7af520574ddaf58a005626938b#0

G9 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 List · 단위 a2ceb96f6eaf18e82155e142cf693ed5#0

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:238-240
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:158-173
  • 17-generation-cards.md §7.1 G9
spec_refs(카드 yaml)
l1v3-168 · l1v3-238
spec_refs(manifest)
l1v3-168 · l1v3-238
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G9.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
생성 · 질의 단위 · 기본 m

G10 언어와 표기

전달 저하 준수 근처 4.24% [3.51–5.10] 질의

무엇

이름
언어와 표기
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
same같음
different다름결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 언어, 표기 보존(l1-system-v3:158–173)
주 근거
① 규약 위반
53 목표(제안)
0–2%
53 달성
미달

무엇을 잡나

생성이 원문을 번역하거나, 한 문서 안에서 두 언어를 섞거나, 고유명사, 약어, 통화와 단위 기호, 뜻을 나르는 기호의 표기를 바꾸는 일을 잡는다. 값은 입력에 적힌 언어와 표기를 그대로 쓰는 것이 생성 규약이다(l1v3-160, l1v3-168). 생성 링크의 책임이고 원문과 생성 글을 견주며, 장식과 구두 기호의 생략, 띄어쓰기, 오타 교정, 연도 표기 보정은 같음으로 본다(G10 v2). 원문에 없는 수와 단위는 G9 몫이다.

어떻게

질문

생성 글(query_yaml 의 값)의 언어가 원문과 같은가? 고유명사, 약어, 수치와 단위의 표기가 원문대로인가?
different: 번역(원문이 일본어인데 값이 한국어), 한 문서 안에서 같은 낱말을 두 언어로 씀, 고유명사나 약어의 표기 체계를 바꿈(로마자화, 한자 변환, 다른 이름), 통화나 단위 기호를 낱말로 풀거나 원문에 없는 단위를 붙임, 뜻을 나르는 기호(상태 이모지, +, 화살표, 수식 기호, 통화 기호)를 빼거나 바꿈, 수치 표기가 다른 값으로 읽히게 바뀜.
same: 그 밖. 장식과 구두 기호(괄호, 마침표, 쉼표, 별표, ※, 전화 기호, 동그라미 숫자, 구분 기호 / 를 다른 구분 기호로)의 생략이나 교체, 띄어쓰기, 오타 교정, 연도 표기 보정(’24년 을 2024년 으로), 천 단위 쉼표 생략, 글을 줄여 씀, 항목 하나를 둘로 나눔, title 의 글(제목의 출처는 프롬프트가 정하지 않았다).
입력 자료
source_text query_yaml spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
277 단위 · fable+gpt55 142 · fable-N(단독) 135
정답 대조 수 · 양성
277 · 양성 5
정밀도
0.22
재현율
0.40
F1
0.29
반복 일치(3회 최빈 비율)
0.96
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 94.7% · 결함 여부 94.7%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
4.24% × 0.22 ÷ 0.40 = 2.35%

한계

  • 관문(25 문서 3절): F1 0.29, 양성 5
  • 30 문서 4.2: 라벨 적음

결과

4.24% [3.51–5.10]

106/2,502 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 라벨 적음
측정값 [95%]
4.24% [3.51–5.10] · 106/2,502 질의
보정값
—
판정
준수 근처
신뢰도 표지
라벨 277 · 정밀도 0.22 · 반복 0.96
25 문서 판정
측정 중
쉬운 / 어려운 조건
3.6% / 6.1%
찾기 차이 / 확인 차이
+2.1 [-1.0–6.2] / +3.1 [-2.2–9.0]
목표(제안) · 근거
0–2% · 규약
규약 참고(53)
0–2%
도달 · 거리
(미달) · +2.24%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
4.21% [2.42–7.21] 12/285
답 분포(30c, 운영 조건 셀)
same: 11,828(94.5%), different: 682(5.5%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-g5 생성 유형 2.5 텍스트와 사람 대 생성 유형 2.5 텍스트와 사람 밖0.51% 2/3934.94% 103/2,085텍스트 종은 원문 표기를 그대로 옮긴다(제안)

채택 연결

자료 없음

사례

G10 사례 결과 그림
결과

모델 답 다름 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 Steps · 단위 c18c33cba696efdf8969a2a2e0030e0a#0

모델 근거(5회 중 첫 답): 원문의 아래쪽 화살표(↓)를 L1에서는 오른쪽 화살표(→)로 바꾸고, L2에서는 생략했습니다.

G10 사례 결과 그림
결과

모델 답 다름 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 451f4f902087e268e9c05352dabe270f#1

모델 근거(5회 중 첫 답): L1에서 ‘쥐라 석회암 → 산’의 의미를 나르는 화살표를 생략했습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:158-173
  • 17-generation-cards.md §7.1 G10
  • 30-human-truth-fable.md(라벨러는 구두 기호 생략을 다름으로 보지 않았다)
spec_refs(카드 yaml)
l1v3-160 · l1v3-168 · l1v3-174
spec_refs(manifest)
l1v3-160 · l1v3-168 · l1v3-174
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G10.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
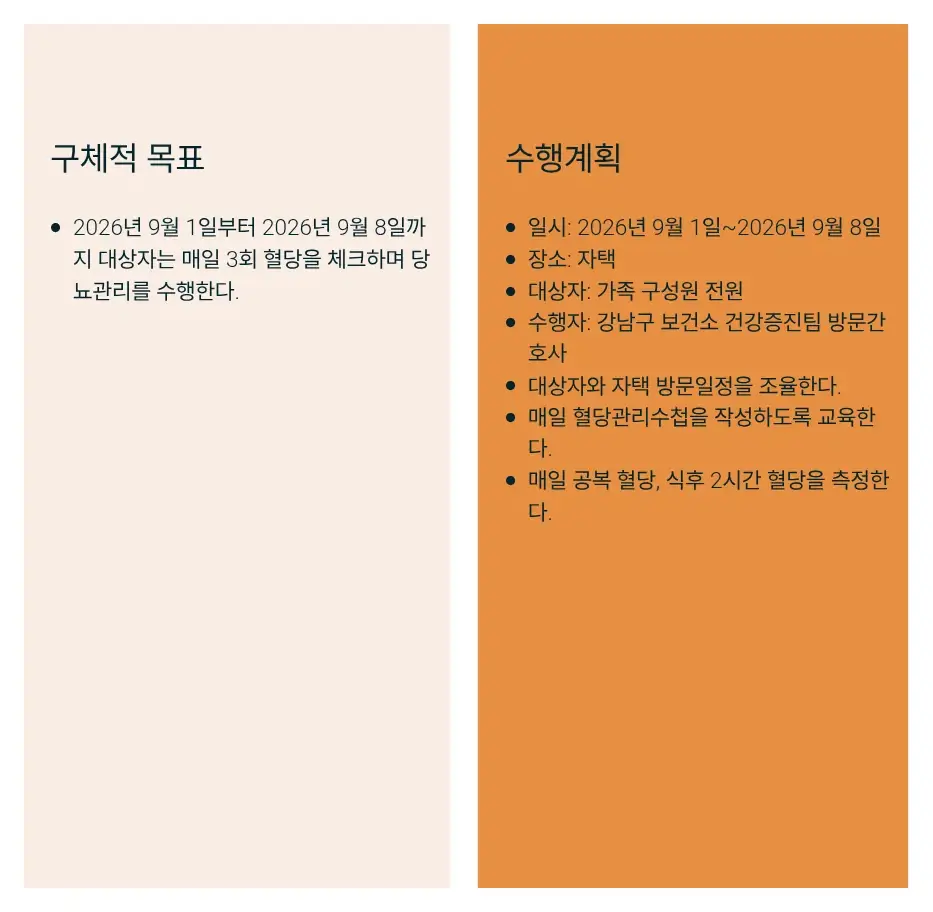
생성 · 질의 단위 · 기본 m

G12 항목 분할

전달 저하 미준수 11.2% [10.1–12.5] 질의

무엇

이름
항목 분할
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
same원문의 나눔과 같다
alt_valid다르지만 타당한 읽기
merged_or_split같은 기준에서 합치거나 쪼갬
wrong_axis맞지 않는 기준이나 층결함전달 저하

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

생성이 entities(label)를 원문의 나눔과 다른 기준이나 층으로 자르는 일, 예로 원문 일부의 하위 나열만 따르거나 큰 덩어리와 그 안의 작은 단위를 한 줄에 섞는 일을 잡는다. 원문의 구조를 옮기는 것은 생성기의 책임이라 생성 링크의 기본 품질이다(기본품질 20, 유저 승인 10/23). 원문과 생성 L1 YAML 을 견주며, 표지 없는 한 덩어리 입력은 타당한 읽기가 여럿이라 그중 하나면 결함이 아니다(같은 문서 유저 확인 10/23). G12 는 무엇을 한 항목으로 보았나, G13 은 항목 안 소속, G3 은 항목 수의 누락이다.

어떻게

질문

생성(query_yaml L1)의 entities(label)가 원문의 나눔과 같은 기준, 같은 층으로 잘렸는가. 원문과 생성만 보고 판단한다. 답은 둘이다. 먼저 원문의 나눔 꼴(form)을 정하고, 그다음 주 답(answer)을 고른다.
[1] 원문의 나눔 꼴 form (근거 칸 맨 앞에 `form=explicit`, `form=semantic`, `form=single` 중 하나를 적고 한 줄로 이유를 잇는다. 예: `form=semantic; 표지 없이 한 문단이나 원인, 과정, 결과로 읽힌다`)
- explicit: 원문이 머리말, 번호, 줄 나눔, 「첫째, 둘째」 같은 표지로 나눔을 드러냈다.
- semantic: 표지 없이 한 덩어리(한 문단, 한 입력)지만 뜻으로 나눔을 읽을 수 있다. 읽는 길이 여럿일 수 있다.
- single: 나눌 것이 없는 한 항목이다.
[2] 주 답 answer
- same: 생성의 항목이 원문의 나눔과 같다(explicit 이면 원문이 드러낸 단위, semantic 이면 가장 자연스러운 읽기).
- alt_valid: 원문이 나눔을 명시하지 않았고(semantic), 생성의 나눔이 원문 읽기의 하나로 타당하다. 가장 자연스러운 읽기와 다르더라도 결함이 아니다.
- merged_or_split: 나누는 기준은 같은데 일부 항목을 합치거나 쪼갰다.
- wrong_axis: 어떤 타당한 읽기에도 맞지 않는 기준이나 층으로 잘랐다. 예: 원문 일부(하위 나열, 한 덩어리 안의 화살표 나열)만 따라 나눴다, 큰 덩어리와 그 안의 작은 단위를 한 줄에 섞었다, 원문의 나눔과 무관한 label 을 새로 지었다.
- form=single 이면 answer 는 same 이다.
- explicit 이면 원문이 드러낸 나눔이 기준이다. 생성의 나눔이 이와 다르면 alt_valid 로 보지 않고 merged_or_split 이나 wrong_axis 로 답한다.
- semantic 이면 타당한 읽기가 여럿일 수 있으므로, 생성의 나눔이 그중 하나로 설명되면 alt_valid 다. 결함(wrong_axis)은 어떤 읽기로도 설명되지 않을 때만이다.
예(사례 3bddb190): 원문은 「문제 원인 / 해결 과정 / 그 결과」 세 덩어리다. 생성이 ProcessFlow.Steps 의 label 을 「문제 대상자 분석, 사전교육·멘토링, 단계적 업무 배치, 취업 연계」 넷으로 두었다. label 이 원문의 세 덩어리가 아니라 해결 과정 안의 화살표 나열(하위 나열)을 따랐으므로 wrong_axis 다.
세지 않는다(다른 카드의 몫): 항목이 몇 개 빠졌는지(G3), 순서가 바뀌었는지(G4), 글이 사라지거나 지어졌는지(G7, G8), 유형이 맞는지(G1), label 아래 items 의 소속(G13). 분할이 wrong_axis 면 G3 의 누락 수는 뜻이 없다. 이 질문은 「무엇을 한 항목으로 보았나」만 본다.
입력 자료
source_text query_yaml
측정기
LLM
정답 종류
human
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.91
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.2: 라벨 없음

결과

11.2% [10.1–12.5]

302/2,687 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 라벨 없음
측정값 [95%]
11.2% [10.1–12.5] · 302/2,687 질의
보정값
—
판정
미준수 (보류 겸)
신뢰도 표지
라벨 없음 · 반복 0.91
25 문서 판정
측정 중
쉬운 / 어려운 조건
9.8% / 15.4%
찾기 차이 / 확인 차이
+6.5 [1.1–13.2] / +4.8 [-1.8–11.6]
목표(제안) · 근거
9.85–11.22% · 쉬운 조건(잠정)(G-a)
규약 참고(53)
자료 없음
도달 · 거리
(미달(구간 겹침)) · +0.02%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
same: 6,157(76.4%), alt_valid: 309(3.8%), merged_or_split: 601(7.5%), wrong_axis: 994(12.3%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-e L1 dataset 없음 대 L1 dataset 있음6.38% 133/2,08428.0% 168/599표를 행으로 나눌지 열로 나눌지 정해야 한다(05 문서 1.1, 생성 프롬프트 「수치 셋을 가른다」)
G-g5 생성 유형 2.5 텍스트와 사람 대 생성 유형 2.5 텍스트와 사람 밖2.80% 11/39312.7% 290/2,290텍스트 종은 나눌 항목이 없다(제안)

채택 연결

자료 없음

사례

G12 사례 결과 그림
결과

모델 답 맞지 않는 기준이나 층 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 ListingTable · 단위 d74aefcb967086e1406748a3d275cea5#3

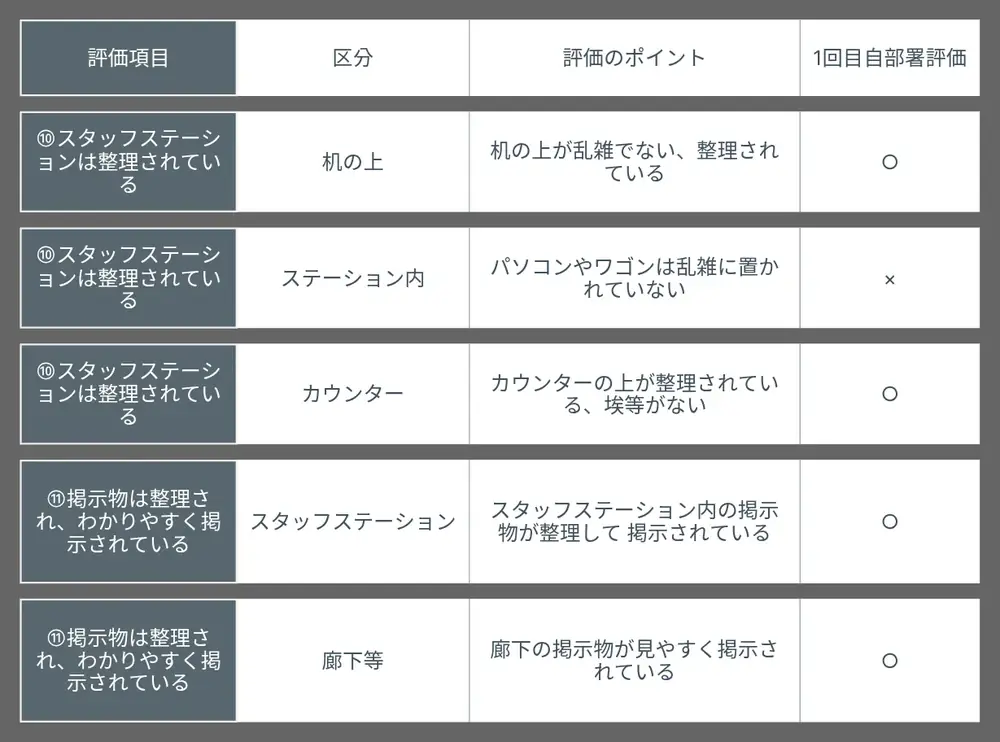
모델 근거(3회 중 첫 답): form=explicit; 원문은 표의 「評価項目」 열에서 ①~⑱로 구분하고, 생성 entities는 이를 하나로 묶어 「評価項目別の自部署評価」라는 별도 기준으로 제시했다.

G12 사례 결과 그림
결과

모델 답 맞지 않는 기준이나 층 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 ListingTable · 단위 df58d4cdc835d5fcb2dad20fd300860a#0

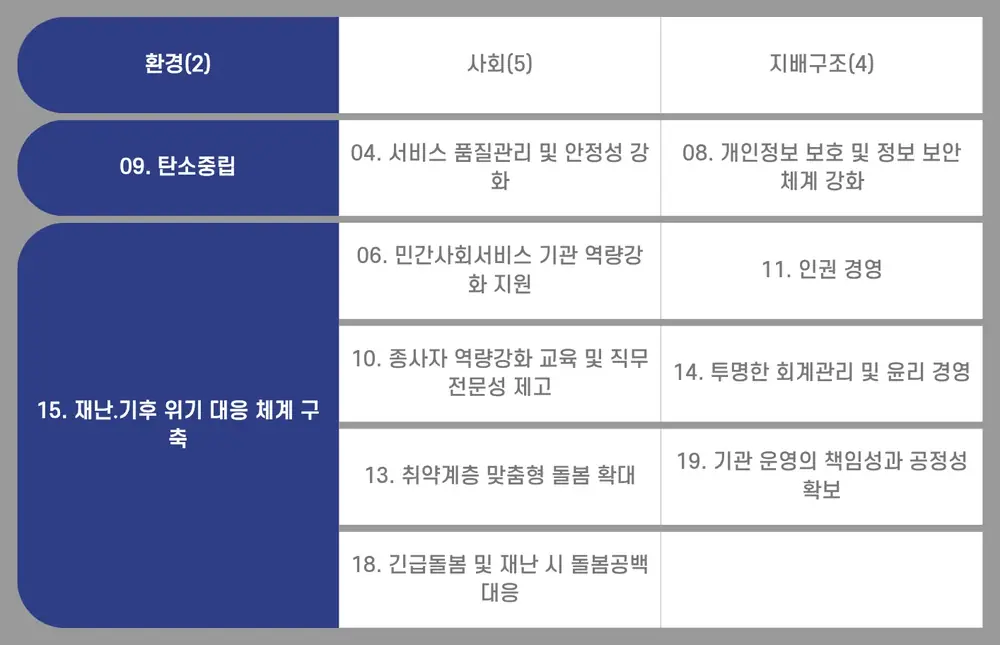
모델 근거(3회 중 첫 답): form=explicit; 원문은 표의 환경·사회·지배구조 세 열로 항목을 나눴지만, 생성 entities는 전체 표 제목 하나만 두어 그 나눔과 다른 층을 기준으로 삼았다

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:41-68
  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:287-299
  • 20-generation-structure.md (G12 항목 분할, 2026-10-23)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G12.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
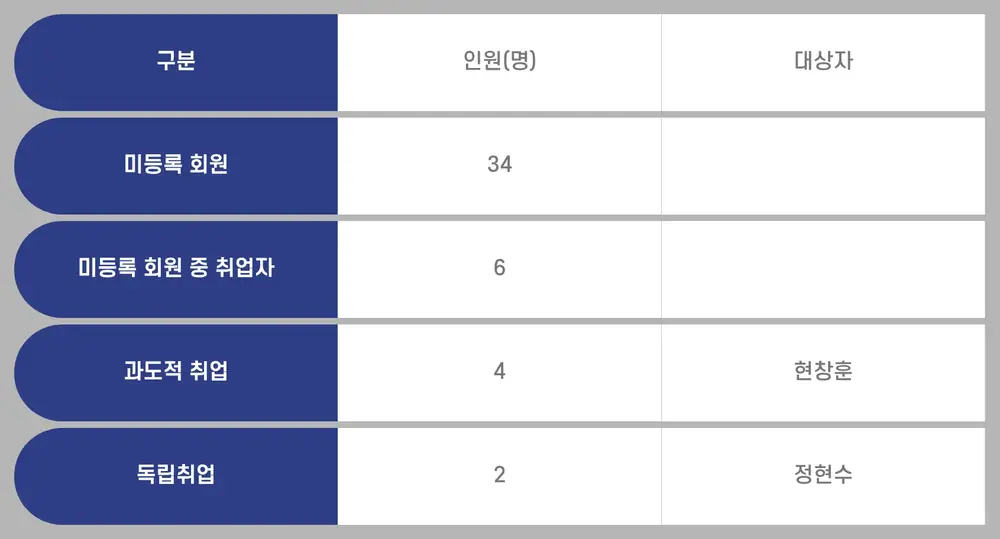
생성 · 질의 단위 · 기본 m

G13 항목 소속

내용 오류 전달 저하 준수 판정 없음 7.89% [6.93–8.97] 질의

무엇

이름
항목 소속
링크
생성
단위(셀)
질의
기본 m
기본 m 측정 중(값만)
등급
내용 오류 전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
all_fit모두 속함
some_misplaced일부가 다른 label 몫결함전달 저하
unrelatedlabel 과 items 사이 논리 없음결함내용 오류

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

생성의 label 아래 items 가 그 label 의 몫이 아닌 일, 곧 원문의 다른 덩어리에 있던 글이 이 label 아래 들어가거나 label 과 items 사이에 논리가 없는 일을 잡는다. 원문의 구조를 옮기는 것은 생성기의 책임이라 생성 링크의 기본 품질이다(기본품질 20, 유저 승인 10/23). 원문과 생성 L1 YAML 을 견준다. label 나눔은 G12, 누락은 G3, 순서는 G4 몫이라, 나눔이 원문과 달라도 label 아래 items 가 어울리면 결함이 아니다.

어떻게

질문

생성(query_yaml L1)의 각 항목(label) 아래 items 가 그 label 에 논리적으로 속하는가. 원문과 생성만 보고 판단한다.
- all_fit: 모든 label 아래 items 가 그 label 의 내용이다(원문에서도 그 label 몫이다). items 가 없는 label 은 판정에서 뺀다.
- some_misplaced: 한두 items 가 다른 label 의 몫이다(원문에서 다른 덩어리에 있던 글이 이 label 아래 들어갔다).
- unrelated: label 과 그 아래 items 사이에 논리가 없다. 거의 모든 items 가 label 과 무관하거나 label 이 items 를 설명하지 못한다.
예(사례 3bddb190): label 「문제 대상자 분석」 아래 items 가 원문의 문제 원인 문장이다. 분석이라는 단계 이름과 원인 문장 사이에 논리가 없어 unrelated 다.
세지 않는다(다른 카드의 몫): label 을 어떻게 나눴는가(G12), 항목이 빠졌는가(G3), 순서(G4), 글의 누락과 지어냄(G7, G8), 유형(G1). 항목 나눔이 원문과 달라도 그 label 아래 items 가 그 label 에 어울리면 all_fit 이다.
입력 자료
source_text query_yaml
측정기
LLM
정답 종류
human
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.1: 라벨 없음, 15 단위

결과

7.89% [6.93–8.97]

212/2,687 질의 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

행 1/2

등급
내용 오류 결함 답 unrelated
목표 수준
0
기준값과 출처
바닥 라벨 없음, 15 단위
측정값 [95%]
0.59% [0.50–0.69] · 150/25,613 장
보정값
—
판정
준수 (바닥)
신뢰도 표지
라벨 없음 · 반복 0.98

행 2/2

등급
전달 저하 결함 답 some_misplaced
목표 수준
원본 수준
기준값과 출처
4절 행 없음 30 문서 4절 표에 이 결함 답의 행이 없다
측정값 [95%]
6.72% [6.42–7.03] · 1,720/25,613 장
보정값
—
판정
판정 없음 30 문서 4절 표에 판정 행 없음
신뢰도 표지
라벨 없음 · 반복 0.98
25 문서 판정
측정 중
쉬운 / 어려운 조건
2.2% / 25.4%
찾기 차이 / 확인 차이
+24.3 [16.8–33.0] / +21.9 [15.3–30.4]
목표(제안) · 근거
2.23–2.97% · 쉬운 조건(G-a)
규약 참고(53)
자료 없음
도달 · 거리
(미달) · +4.92%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
all_fit: 7,425(92.1%), some_misplaced: 587(7.3%), unrelated: 49(0.6%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
G-a L2 컴포넌트 하나 대 L2 컴포넌트 둘 이상2.23% 45/2,02125.4% 167/657items 를 어느 컴포넌트의 label 아래 둘지 정할 일이 없다(20 문서 G13, 제안 해석)
G-g2 생성 유형 2.2 순서와 흐름 밖 대 생성 유형 2.2 순서와 흐름4.92% 113/2,29625.6% 99/387단계마다 설명을 귀속시키는 판단이 많다(제안)

채택 연결

자료 없음

사례

G13 사례 결과 그림
결과

모델 답 일부가 다른 label 몫 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 LongFormTextLayout · 단위 ea1c00543fdcd2e72c41f7c414ebadc1#0

모델 근거(3회 중 첫 답): 논문 정의와 학위논문에 요구되는 내용을 ‘창의성’ 아래 두었지만, 원문은 이를 창의성의 내용으로 제시하지 않는다.

G13 사례 결과 그림
결과

모델 답 label 과 items 사이 논리 없음 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 88c54b01e76737c44a8899e7fadec67f#0

모델 근거(3회 중 첫 답): 각 단계 label 아래 설명·일상 예시·유의사항이 들어 있어 해당 만들기 단계의 내용이 아니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • rust/comp-pass/crates/comp-pass-logic/prompts/l1-system-v3.txt:41-68
  • 20-generation-structure.md (G13 소속, 2026-10-23)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/G13.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
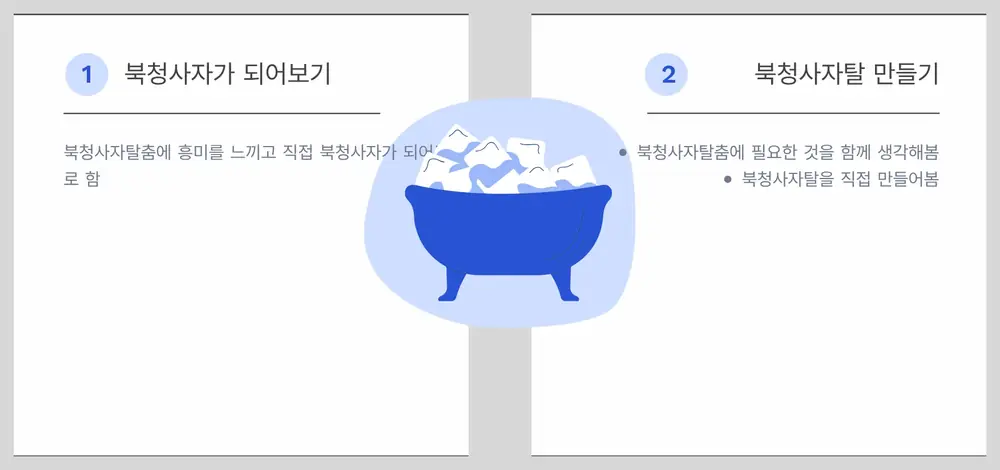
색인 · 장 단위 · 기본 m

B1 core 경계가 의미 단위를 감싸지 못함

보류 운영 조건 값 없음

무엇

이름
core 경계가 의미 단위를 감싸지 못함
링크
색인
단위(셀)
장
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
exact정확히 감쌈
missing빠짐결함
over넘침결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ④ 보조. 경계는 한 의미 단위의 core 를 감싼다(boundary-v12.4 boundary_scope_policy, 같은 category 반복 항목은 한 단위). 색인도 LLM 이고 의미 단위 판단은 갈린다
주 근거
① 규약 위반
53 목표(제안)
3–5%
53 달성
미달(잠정)

무엇을 잡나

운영 색인이 잡은 경계가 원본의 의미 단위 하나를 다 감싸지 못하거나(나란한 항목 일부, 표의 행이나 열이 밖에 남음), 표제와 자리가 따로인 별개 묶음 둘을 한 경계로 감싸는 일을 잡는다. 검색이 고르는 단위가 경계라 의미 단위를 바르게 감싸야 맞는 컴포넌트를 고를 수 있다(기본품질 13 1.1, b124-13). 색인 링크의 책임이고 원본 그림과 트리만 보고 판단하며, 정답 색인 대비는 신뢰도용이다(평가틀 47 원칙). 같은 종류의 반복 항목을 함께 감싼 것은 결함이 아니고(b124-18), 다른 표현이 섞인 것은 B3, 위성과 root 과잉은 B4 몫이다.

어떻게

질문

운영 색인이 이 DO 에서 잡은 경계(그림의 빨간 상자, component_tree 의 boundary_node 와 in_boundary, frame_tree_plain 의 노드)가 원본 컴포넌트의 의미 단위 하나를 빠짐없이, 넘치지 않게 감싸는가. 원본 그림과 트리만 보고 판단한다.
- exact: 경계가 한 의미 단위(나란히 늘어선 항목 묶음, 표, 차트, 단계 흐름, 글 블록 등)의 core 를 모두 담고, 다른 단위의 core 는 담지 않는다.
- missing: 같은 의미 단위에 속하는 core(나란한 항목 하나 이상, 표의 행이나 열, 차트의 축이나 범례, 큰 수치와 그 이름표)가 경계 밖에 남았다.
- over: 경계가 이 의미 단위 밖의 core 까지 함께 감쌌다. 같은 종류라도 각자 자기 표제와 자리를 가진 별개의 묶음 둘(표제가 따로 붙은 두 목록, 좌우로 갈린 두 표)을 한 경계로 감싼 경우다.
- 같은 category 의 반복 항목(카드, 행, 단계, 번호 항목, Before 와 After 처럼 짝을 이룬 두 쪽)은 하나의 의미 단위를 이루는 구성요소다(boundary-v12.4 규칙 6). 항목이 서로 독립된 내용이어도 나란히 늘어선 항목 묶음 전체가 한 단위이므로 그것을 함께 감싼 것은 over 가 아니라 exact 다.
- 빨간 상자가 없으면 경계가 DO 전체(root)다. DO 전체가 한 의미 단위면 exact 다.
입력 자료
origin_marked component_tree frame_tree_plain spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 gold_boundary_check
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다)
53 문서 근거
① 규약 위반 · 53 목표(제안) 3–5%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
3–5% · 규약
규약 참고(53)
3–5%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 15.2% [13.6–17.0] 265/1,738
표본 250 운영 조건
18.5% [16.7–20.5] 298/1,610
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다))

출처

  • prompts/boundary-v12.4.txt:13(boundary 는 core 만), :18(반복 항목은 구성요소이지 별도 경계가 아니다), :31-32(core 와 satellite), :40-44(canonical wrapper)
  • policy/iis-boundary-gold-core-scope.md:70(canonical 규칙, core 잎만 센다)
  • 47-decisions-1020.md 원칙(평가는 운영 기준, 정답은 신뢰도용), 54-index-g7-operating.md
  • 신뢰도 정답 gold_boundary_check = I0 의 B1 하위 판정(정답 색인 gold-iis-final-v3 대비)
spec_refs(카드 yaml)
b124-13 · b124-31 · b124-40 · b124-18
spec_refs(manifest)
b124-13 · b124-31 · b124-40 · b124-18
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/B1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
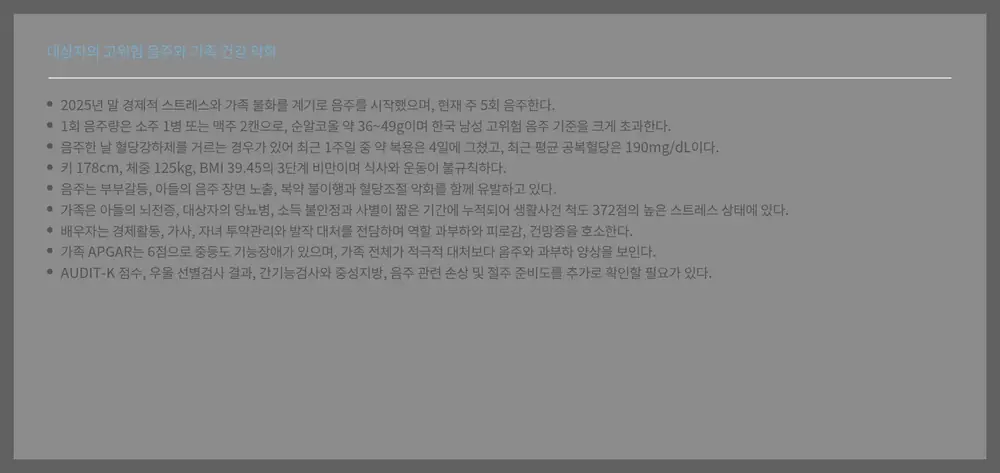
색인 · 장 단위 · 기본 m

B2 카테고리가 컴포넌트에 맞지 않음

보류 운영 조건 값 없음

무엇

이름
카테고리가 컴포넌트에 맞지 않음
링크
색인
단위(셀)
장
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
fit맞음
broad_ok넓은 쪽으로 무난
unfit맞지 않음결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 카테고리 부여 규칙(boundary-v12.4 task_contract 4, 5, confusion_rules). 49종 경계가 자의적이라 G1 과 같은 여유
주 근거
① 규약 위반
53 목표(제안)
2–5%
53 달성
달성(잠정)

무엇을 잡나

운영 색인이 경계에 붙인 카테고리가 모두 원본 컴포넌트의 구조와 무관하거나, 없는 구조(순서, 수치 축, 표, 시간)를 지어내는 일을 잡는다. 검색의 유형 맞춤이 이 카테고리를 쓰므로 부여 오류는 곧 검색 오류가 된다(기본품질 13 1.1, b124-16). 색인 링크의 책임이고 원본 그림과 경계 트리만 보고 판단하며, 정답 카테고리 대비는 신뢰도용이다(평가틀 47 원칙). 좁은 종이 또렷하지 않아 넓은 쪽을 붙인 것은 무난이고, 표, 차트 종과 격자 요소의 어긋남은 P3 몫이다.

어떻게

질문

운영 색인이 이 경계에 붙인 카테고리(frame_iis 의 카테고리, 여럿이면 전부)가 원본 컴포넌트(그림의 빨간 상자 안, 상자가 없으면 DO 전체)에 맞는가. 원본 그림과 경계 트리만 보고 판단한다.
- fit: 붙은 카테고리 가운데 하나 이상이 컴포넌트의 구조(나열, 단계, 비교, 표, 차트, 계층, 시간 흐름, 수치 강조, 글 블록 등)를 그대로 나타낸다.
- broad_ok: 좁은 종이 또렷하지 않아 넓은 쪽(Enumeration_List, TextBasedCommunication_LongFormTextLayout, HighlightedMessage)이나 같은 가족의 넓은 종으로 붙였다. 내용 구조가 틀리지 않으므로 무난하다.
- unfit: 붙은 카테고리가 모두 컴포넌트 구조와 무관하거나, 컴포넌트에 없는 구조(순서, 수치 축, 표, 시간)를 지어낸다. Unclassified 만 붙었는데 컴포넌트가 한 표현으로 또렷하면 unfit 이다.
- 49종 분류는 경계가 자의적이다. 「더 좁은 종이 더 나을 수 있다」 정도는 unfit 이 아니다.
입력 자료
origin_marked frame_tree_plain frame_iis spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 gold_category_check
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다)
53 문서 근거
① 규약 위반 · 53 목표(제안) 2–5%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
2–5% · 규약
규약 참고(53)
2–5%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 15.2% [13.6–17.0] 264/1,738
표본 250 운영 조건
3.91% [3.07–4.98] 63/1,610
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다))

출처

  • prompts/boundary-v12.4.txt:16-17(task_contract 4, 5), :51-102(capability manifest), :205-225(confusion_rules)
  • 47-decisions-1020.md 원칙, 54-index-g7-operating.md
  • 신뢰도 정답 gold_category_check = I0 의 B2 하위 판정(정답 색인 gold-iis-final-v3 대비, 사다리 아래쪽은 broader_same_family)
spec_refs(카드 yaml)
b124-16 · b124-213 · b124-51
spec_refs(manifest)
b124-16 · b124-213 · b124-51
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/B2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

B3 경계가 하나의 의미 단위가 아님

보류 1.23% [1.11–1.37] 장

무엇

이름
경계가 하나의 의미 단위가 아님
링크
색인
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
one하나
mixed섞임결함
cut잘림결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④ 한 표현인지는 판단이 갈린다
주 근거
④ 사람 한계
53 목표(제안)
2–3%
53 달성
달성

무엇을 잡나

결과에 나온 경계 안의 core 가 한 표현을 이루지 못하는 일, 곧 서로 다른 category 의 표현(목록과 표, 카드 묶음과 체크리스트)이 한 경계에 섞이거나 한 표현의 일부만 들어간 일을 잡는다. 자식 경계는 자체로 완결된 표현 단위여야 한다는 것이 색인 규약이고(b124-18), 섞이면 질의 유형과 맞는 컴포넌트라는 판단이 성립하지 않는다(기본품질 13 1.1). 색인 링크의 책임이고 경계 트리와 그림으로 판단한다. 경계 안의 제목, 설명 문단, 배경 같은 위성은 섞임의 근거가 아니고(b124-40) 위성 문제는 B4 몫이다.

어떻게

질문

이 경계 안의 core 가 한 category 의 표현 하나를 이루는가?
표현 = 한 category 의 core(반복 항목, 카드, 행, 단계, 차트 glyph)와 그에 딸린 요소다. 경계 안의 컴포넌트 제목, 부제, 설명 문단, 강조 문구 한 줄, 배경, 장식, 사진, 아이콘, marker 는 그 표현의 위성이거나 보조 요소라 「섞임」의 근거가 아니다(위성 문제는 B4 가 따로 묻는다).
one: core 가 한 표현이다. 반복 항목이 여럿이고 칸마다 제목과 설명이 있어도 같은 종류면 하나다. 좌우 두 열로 나뉜 같은 종류의 항목도 하나다.
mixed: 서로 다른 category 의 core 둘 이상이 한 경계에 있다(목록 + 표, 카드 묶음 + 체크리스트, 단계 흐름 + 비교, 설명 패널 + 점수 행 묶음).
cut: 한 표현의 core 일부만 경계에 들어 있다(반복 항목 가운데 일부, 표의 행 일부, 차트의 glyph 일부). 글이 상자 밖으로 나간 것(D8)은 잘림이 아니다.
경계 안 요소는 frame_tree 의 노드뿐이다. 그림에 함께 보이는 경계 밖 요소(frame_tree 에 없는 차트, 다른 카드)는 판단에 넣지 않는다.
입력 자료
result_thumb frame_tree spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
448 단위 · fable+gpt55 148 · fable-N(단독) 300
정답 대조 수 · 양성
447 · 양성 13
정밀도
0.36
재현율
0.31
F1
0.33
반복 일치(3회 최빈 비율)
0.99
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 98.7% · 결함 여부 98.7%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
1.23% × 0.36 ÷ 0.31 = 1.45%

한계

  • 관문(25 문서 3절): F1 0.33, 양성 13

결과

1.23% [1.11–1.37]

350/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
사람 판단 갈림 수준
기준값과 출처
사람 판단 갈림 사람 직접 라벨 0 · 사람끼리 일치 값 없음
측정값 [95%]
1.23% [1.11–1.37] · 350/28,445 장
보정값
1.45% = 1.23% × 0.36 ÷ 0.31(모델 라벨 양성 13, 참고)
판정
보류 (바닥 근거 없음). 사람 판단이 갈리는 수준을 잴 사람 라벨(라벨러 둘 이상)이 없다
참고
두 모델(fable 대 gpt55) 결함 여부 갈림 1.33%(150 쌍, 모델 라벨이라 사람 값이 아니다)
참고
3회 반복 일치 0.99(측정기 값)
53 문서 근거
④ 사람 한계 · 53 목표(제안) 2–3%
신뢰도 표지
라벨 447 · 정밀도 0.36 · 반복 0.99
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
(도달) · -1.77%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
1.71% [1.30–2.24] 51/2,985
답 분포(30c, 운영 조건 셀)
one: 100,490(98.1%), mixed: 1,627(1.6%), cut: 314(0.3%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-c 반복 묶음 없음 대 RLSC 반복 묶음 있음0.36% 43/11,8601.85% 307/16,585반복 묶음이 여럿이면 경계가 묶음 여럿을 한 단위로 삼는다(제안, 15 문서 B3 「복수 정보블록 경계」와 같은 자리)
I-h5 컴포넌트 카테고리 2.5 텍스트와 사람 대 컴포넌트 카테고리 2.5 텍스트와 사람 밖0.08% 4/5,0181.48% 346/23,427글 한 덩어리라 의미 단위가 하나다(제안)

채택 연결

자료 없음

사례

B3 사례 결과 그림
결과

모델 답 섞임 · 반복 5회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 ce206a52a3346eaa53bbe6b3acac6a91#0

모델 근거(5회 중 첫 답): 왼쪽은 반복 문구 항목 묶음이고 오른쪽은 제목과 설명으로 된 별도 패널 묶음이다.

B3 사례 결과 그림
결과

모델 답 잘림 · 반복 3회 중 최빈 비율 1.00 · 순위 7 · 유형 ListingTable · 단위 ba276a95973d2bdc28a2c02d727cbbf3#3#r7

모델 근거(3회 중 첫 답): 반복되는 동일한 행 표현 중 마지막 행은 core 일부만 표시되어 있어 완결된 한 표현이 잘렸습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • prompts/boundary-v12.4.txt:18(task_contract 6)
  • prompts/boundary-v12.4.txt:21(task_contract 9)
  • prompts/boundary-v12.4.txt:40-44(canonical 규칙 (a)-(e))
  • 30-human-truth-fable.md(라벨러 규칙: 경계 밖 제외)
spec_refs(카드 yaml)
b124-18 · b124-20 · b124-40
spec_refs(manifest)
b124-18 · b124-20 · b124-40
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/B3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

B4 위성을 경계에 넣었거나 root 를 과잉으로 경계로 둠

준수 0.51% [0.43–0.60] 장

무엇

이름
위성을 경계에 넣었거나 root 를 과잉으로 경계로 둠
링크
색인
단위(셀)
장
기본 m
기본 m 판정, 도달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
none없음
satelliteroot 직접 자식인 위성이 경계 안에 있음결함
root_excessroot 과잉(content 자식이 하나뿐인 root 가 경계)결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ② 보조. boundary 프롬프트 task_contract 1, 8. 색인도 LLM 이라 생성 폭
주 근거
① 규약 위반
53 목표(제안)
3–5%
53 달성
미달

무엇을 잡나

색인이 컴포넌트 전체 제목, 부제, 번호 marker, 전체 배경 같은 위성을 경계에 넣거나, 내용 자식이 하나뿐인데 root 를 경계로 두는 일을 잡는다. 경계는 core 만 덮고 위성을 덮으려 root 를 경계로 두지 않는 것이 색인 규약이며(b124-13, b124-281), 위성이 경계에 들면 질의 몫과 무관한 자리가 생긴다(기본품질 13 1.1). 색인 링크의 책임이고 RLSC 트리의 root 직접 자식을 규칙으로 본다. root 가 유일하게 가능한 경계라 피할 수 없는 위성, 강조 메시지 본문, 큰 그림은 결함이 아니다(기본품질 14 Q1, Q2, Q3).

어떻게

질문

component_tree 의 root 직접 자식만 보고 판정한다. frame_tree 의 depth 0 노드는 경계이지 root 가 아니다.
boundary_is_root 가 true 면 root 직접 자식 전부가 경계 안이고(in_boundary 표시와 무관), false 면 boundary_node 하나만 경계 안이다.
(1) 경계 안의 root 직접 자식 가운데 위성이 있으면 satellite. 위성 = 컴포넌트 전체를 이름 붙이는 Title, Subtitle 글이나 Title, Marker 컨테이너(설명 문장 Description 이 함께 묶이지 않은 것), root 상자 전체를 덮는 Background 한 장, 작은 ornament 나 Separator.
단 boundary_is_root 가 true 이고 root 가 유일하게 가능한 경계이면 위성이 있어도 none 이다. 유일한 경계 = 위성 밖의 content 자식이 둘 이상이거나, content 자식이 모두 Element(글 한 장, 그림 한 장 등 role 이 Element 인 노드)인 경우. 위성이 경계에 드는 것을 피할 수 없어 색인 결함이 아니다.
위성이 아닌 것: 카테고리에 HighlightedMessage 가 있고 Title role 자식의 가장 큰 글이 컴포넌트 전체에서 가장 큰 글(상자 높이 기준, VS 같은 구조 토큰 제외)이면 그 자식은 강조 메시지 본문이라 content 다. Decoration 컨테이너 안에 root 면적의 10% 이상인 Image, SVG 가 있으면 큰 그림이라 content 다.
(2) 위성이 없고 boundary_is_root 가 true 인데 content 자식이 정확히 하나이고, 그 자식이 Element 한 장(Chart, Image, SVG)이 아니며, result_meta.categories 에 Unclassified 가 없으면 root_excess.
(3) 그 밖은 none. content 자식이 둘 이상인 root 경계는 root_excess 가 아니다. 경계가 root 의 자식 하나이고 그 자식이 content 면 none 이다.
세지 않는 것: root 직접 자식보다 깊은 곳의 항목별 번호 marker, 카드 배경, 아이콘, 항목 제목(그 표현의 core 다). 경계가 root 의 자식이면 그 경계 안의 배경과 제목은 그 표현의 것이라 위성이 아니다.
입력 자료
component_tree result_meta frame_tree spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 root_satellite_role_check
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 0 (규칙 대조)
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.96
규칙 대조 일치
0.95 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

0.51% [0.43–0.60]

143/28,245 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
정답 조건 a1 14.8% [10.8–19.9] 34/230(표본 250)
측정값 [95%]
0.51% [0.43–0.60] · 143/28,245 장
보정값
—
판정
준수 목표 0 · 바닥 = 정답 조건 a1. 2,000 운영 하한 0.43% 대 바닥 상한 19.9%: 바닥 이하이거나 겹친다
기준값 대조
같은 판(표본 250) 안에서 O 11.9% [10.8–13.2] 대 바닥 상한 19.9%: 겹친다
기준값 대조
카드 판 250→2,000 = 2→4(17 문서 3.4). 정답 조건 값은 옛 판 값이다
53 문서 근거
① 규약 위반 · 53 목표(제안) 3–5%
신뢰도 표지
규칙 대조 200 · 양성 0 · 반복 0.96
25 문서 판정
확정
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
3–5% · 규약
규약 참고(53)
3–5%
도달 · 거리
도달 · -4.49%p
정답 조건 값(표본 250 export)
조건 a 16.2% [12.0–21.6] 37/228 · 조건 a1 14.8% [10.8–19.9] 34/230
표본 250 운영 조건
11.9% [10.8–13.2] 352/2,946
답 분포(30c, 운영 조건 셀)
none: 560(93.3%), satellite: 18(3.0%), root_excess: 22(3.7%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-c RLSC 반복 묶음 있음 대 반복 묶음 없음0.13% 22/16,5841.04% 121/11,661반복 묶음에 경계를 맞추면 위성이 밖에 남는다(05 문서 2.1)
I-h1 컴포넌트 카테고리 2.1 나열과 비교 대 컴포넌트 카테고리 2.1 나열과 비교 밖0.32% 61/18,7990.87% 82/9,446나열 종은 경계가 목록 하나로 정해진다(제안)

채택 연결

자료 없음

사례

B4 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 Steps · 단위 47d0c5b6ac4c4f91c13663028625f828#0#r2

B4 사례 결과 그림
결과

규칙 판정 결함 · 순위 7 · 유형 LineAreaChart · 단위 42795319ec5e738680652589c0bf002b#0#r7

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • prompts/boundary-v12.4.txt:13(task_contract 1)
  • prompts/boundary-v12.4.txt:20(task_contract 8)
  • prompts/boundary-v12.4.txt:37-38(boundary_scope_policy)
  • prompts/boundary-v12.4.txt:281(self_check 1)
spec_refs(카드 yaml)
b124-13 · b124-20 · b124-22 · b124-37 · b124-50 · b124-281
spec_refs(manifest)
b124-13 · b124-20 · b124-22 · b124-37 · b124-50 · b124-281
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/B4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

C1 원본 글이 자기 슬롯 용량을 넘음

미준수 8.72% [8.40–9.06] 장

무엇

이름
원본 글이 자기 슬롯 용량을 넘음
링크
색인
단위(셀)
장
기본 m
기본 m 판정, 미달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier confirmed

결함 답과 등급

개수 답(넘치는 슬롯 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 원본 글은 실제로 자기 슬롯에 들어가 있으므로 넘친다는 추정은 추정 오류다. 조항 출처는 없다
주 근거
① 규약 위반
53 목표(제안)
3–5%
53 달성
미달

무엇을 잡나

색인이 적은 슬롯 용량(글자 수, 줄 수)이 그 자리에 실제로 들어 있던 원본 글보다 작은 일을 잡는다. 원본 글은 실제로 들어가 있으므로 넘침은 용량 추정의 오류이고, 검색의 용량 관문과 대치의 넣기가 이 용량을 쓴다(기본품질 13 1.1). 색인 링크의 책임이고 원본 글과 운영 용량을 iui cost.rs 관문과 같은 식의 규칙으로 견주며, 10% 이내 넘침, 라틴과 숫자 글의 폭 환산, 표 칸은 결함에서 뺀다(기본품질 14 Q4, Q5, Q6). C1 은 원인 쪽이고, 결과 그림의 넘침은 D8, 걸러진 후보의 용량 판단은 R2 몫이다(기본품질 19 4절).

어떻게

질문

frame_iis 의 슬롯마다 그 슬롯의 원본 글(frame_tree 에서 같은 노드 id 의 text, 대치 전 글)이 슬롯의 용량을 10% 넘게 넘는가. 넘치는 슬롯 수를 센다.
- 슬롯 = units 의 필드 노드(label, items, value, period 등, 자식 유닛 포함)와 satellites 의 title, subtitle, desc 노드.
- 용량: chars 는 글자 수 용량, charsPerLine 은 줄당 글자 수, lines 는 줄 수 용량이다.
- 글자 폭 환산: 용량은 한글 폭에 맞춰져 있다. 글에서 라틴 문자가 가장 많거나 글자 없이 숫자와 기호만 있으면(14 문서 규칙 정책 Q5) chars 와 charsPerLine 을 1.653 배(한글 폭 0.8597 대 라틴 폭 0.52)로 늘린다.
- 오차 범위(14 문서 규칙 정책 Q4): 환산 뒤의 chars 와 charsPerLine 을 다시 1.1 배로 늘린다. lines 는 늘리지 않는다.
- 넘침 = 늘린 용량으로 보아 글자 수가 chars 를 넘거나, 줄 수가 lines 를 넘는 것. 글자 수는 앞뒤 공백을 뗀 글의 길이다. 줄 수는 글을 줄바꿈으로 나눈 단락마다 (단락 글자 수 / charsPerLine) 을 올림해(빈 단락은 1) 더한 값이다. 한 슬롯이 두 기준을 다 넘어도 1 이다.
- 세지 않는 것: chars 나 lines 가 0 이거나 비어 있는 슬롯(용량 미상, hardLimit 이어도), 원본 글이 없는 노드, 표 자리(grid)와 표 칸, 머리글(14 문서 규칙 정책 Q6, 표 칸 맞춤은 D7, R4 가 본다).
- 상자 폭과 글꼴 크기로 글자 폭을 어림해 줄 수를 바꾸지 않는다. 줄 수는 charsPerLine 으로만 접는다.
입력 자료
frame_tree frame_iis
측정기
규칙
정답 종류
rule · 규칙 slot_capacity_self_overflow
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v7

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 29 (규칙 대조)
정밀도
0.97
재현율
0.97
F1
0.97
반복 일치(3회 최빈 비율)
0.97
규칙 대조 일치
0.96 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
8.72% × 0.97 ÷ 0.97 = 8.72%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

8.72% [8.40–9.06]

2,482/28,457 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
바닥 규칙 대조 200 · 양성 29 · 대조 반복 일치 0.97 · 정밀도 0.97 재현율 0.97
측정값 [95%]
8.72% [8.40–9.06] · 2,482/28,457 장
보정값
8.72% [8.40–9.06] = 8.72% × 0.97 ÷ 0.97
판정
미준수 목표 0 · 규칙 대조 보정 8.72% [8.40–9.06] 대 바닥 선 3.5%(4.1 준수 선례 상한, 제안)
53 문서 근거
① 규약 위반 · 53 목표(제안) 3–5%
신뢰도 표지
규칙 대조 200 · 정밀도 0.97 · 반복 0.97
25 문서 판정
확정
쉬운 / 어려운 조건
7.6% / 13.4%
찾기 차이 / 확인 차이
+5.0 [3.1–7.1] / +6.7 [3.6–11.5]
목표(제안) · 근거
7.56–7.91% · 쉬운 조건(I-f)
규약 참고(53)
3–5%
도달 · 거리
미달 · +0.81%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
18.5% [17.2–20.0] 554/2,987
답 분포(30c, 운영 조건 셀)
0: 510(85.0%), 1: 39(6.5%), 2: 33(5.5%), 3: 8(1.3%), 4: 7(1.2%), 5: 3(0.5%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-a dataset 필수, 규약 밖 종 섞임 대 카테고리 entity 종1.59% 112/7,03611.1% 2,370/21,421C1 이 표 칸을 세지 않는 규칙이라 표, 차트 종이 0 에 가깝다(14 문서 Q6, 23 문서 2.3)
I-f 순번 표식 없음 대 순번 표식(Marker) 있음7.56% 1,722/22,78413.4% 760/5,673순번 표식 자리는 용량이 작아 넘치기 쉽다(제안, 05 문서 2.1 I-f)

채택 연결

자료 없음

사례

C1 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 Steps · 단위 8fa27e81dc330f26a8cb9d4169f02eb0#1#r2

C1 사례 결과 그림
결과

규칙 판정 결함 · 순위 10 · 유형 List · 단위 c6ca750bafcea0cfc7fe75f60b1b7af4#0#r10

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 19-index-cards.md §3 C1(옛 보드 2.4, comp_frame 빌더 몫)
  • 34-fix-round-3.md §1 C1(규칙 게이트와 질문의 어긋남)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/C1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

I0 정답 색인 재현(색인)

띠 운영 조건 값 없음

무엇

이름
정답 색인 재현(색인)
링크
색인
단위(셀)
장
기본 m
기본 m 정답 기준 띠(도달 계산 밖)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
same같음
different다름결함

기본 m 근거(53 문서)

절
2 정답 기준 정상 작동 띠(근거 열 없음)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
0–1%
53 달성
미달

무엇을 잡나

정답 세트 DO 에서 운영 색인이 사람이 검토한 정답 색인과 다른 경계, 카테고리, 자리 지도, 칸 지도, params 를 내는 일을 잡는다. 정답 색인은 정답 세트에만 있어 운영 조건에서는 잴 수 없으므로 정답 조건에서 따로 재는 「정답 기준」 띠 카드다(평가틀 47 결정 6, 평가틀 46 6.5). 색인 링크의 책임이고 비교 대상은 정답 색인이며, 운영 도달 계산에는 넣지 않는다(평가틀 47 결정 6). 한계: 정답 색인이 운영 색인에서 출발해 사람이 고친 것이라 B1, B2, P5 하위 판정은 구조상 0 이고, 실제로 재는 것은 P1(자리 지도)과 P4(칸 지도)뿐이다(기본품질 13 2절, 유저 결정 10/24).

어떻게

질문

정답 세트 DO 의 운영 색인이 정답 색인과 같은가. 아래 하위 판정 가운데 하나라도 결함이면 다르다.
- 경계(B1): 정답 core 노드가 운영 경계 밖에 있거나(빠짐), 운영 경계의 유닛, 칸이 정답 경계 밖 노드를 참조하면(섞임) 결함. 위성은 보지 않는다.
- 카테고리(B2): 운영 카테고리에 정답 카테고리도, 정답 유형의 사다리 아래쪽 유형도 없으면 결함.
- 자리 지도(P1): 정답과 운영의 (유닛, 필드)가 다른 core 글 노드가 있으면 결함.
- 칸 지도(P4): dataset 칸 지도가 전치되었거나 다르면 결함.
- params(P5): 정답 params 키 가운데 운영 값이 다른 것이 있으면 결함.
입력 자료
gold_iis frame_iis
측정기
규칙
정답 종류
rule · 규칙 gold_index_repro
비교 기준
정답 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
rule_extra = gold_index_reasons, 집계 = ratio
카드 버전
v1

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 띠

한계

  • O 2,000 값 없음: 정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)
  • 관문(25 문서 3절): 정답 기준 띠(운영 도달 계산 밖, 47 결정 6)

결과

자료 없음

기준값과 판정(6장 보드)

판정
띠 정답 기준 띠 = 측정기 바닥. 운영 판정 대상이 아니다(53 문서 2절)
25 문서 판정
띠
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
0–1% · 규약
규약 참고(53)
0–1%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 4.20% [3.35–5.25] 73/1,738
표본 250 운영 조건
자료 없음
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)))

출처

  • 47-decisions-1020.md 결정 6
  • rules/gold_index_repro.py(B1 경계, B2 카테고리), slot_map_node_match.py(P1), dataset_map_match.py(P4), iis_params_key_diff_count.py(P5)
  • 정답 IIS gold-iis-final-v3, 운영 색인 스냅샷 2_6-20261015
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/I0.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

P1 자리 지도가 노드 역할에 맞지 않음

보류 운영 조건 값 없음

무엇

이름
자리 지도가 노드 역할에 맞지 않음
링크
색인
단위(셀)
장
기본 m
기본 m 판정 제외
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

개수 답(맞지 않게 묶인 노드 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 노드를 역할에 맞는 유닛과 필드에 묶는다(property v8 할 일 1). 색인 LLM 폭
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

운영 색인의 자리 지도가 노드 역할과 어긋나는 일, 곧 항목 이름이 설명 자리에, 설명 문장이나 수치가 이름 자리에 묶이거나, 한 항목의 노드가 다른 유닛에 묶이거나, 번호 marker 와 전체 제목이 항목 필드에 묶이는 일을 잡는다. 대치가 글을 넣는 자리가 이 지도라 잘못 묶이면 글이 다른 노릇의 자리로 간다(기본품질 13 1.1, p8-10). 색인 링크의 책임이고 원본 그림과 경계 트리로 판단하며, 정답 자리 지도는 신뢰도용이다(평가틀 47 원칙). 어느 자리에도 묶이지 않은 노드는 P2, 칸 지도는 P4 몫이다. 지금은 질문을 재검토 중이라 판정에서 뺀 상태이고(기본품질 14 결정 4), 질문이 정해지면 이 취지도 다시 쓴다(유저 결정 10/24).

어떻게

질문

운영 색인의 자리 지도(frame_iis 의 유닛과 필드: 어느 노드가 어느 항목의 label, items, value, desc, period 등 자리인가)가 원본 노드의 역할에 맞는가. 맞지 않게 묶인 노드 수를 센다. 원본 그림(빨간 상자 = 경계), 경계 트리(frame_tree_plain 의 role, type, text, box)만 보고 판단한다.
센다(노드 하나에 한 번):
- 필드가 역할과 다르다: 항목 이름(짧은 제목 글)이 desc 나 items 에, 설명 문장이 label 에, 수치가 label 에, 기간 글이 label 에 묶였다.
- 유닛이 틀렸다: 한 항목에 속한 노드(그림에서 같은 카드, 같은 행에 붙은 이름과 설명)가 다른 유닛에 묶였거나, 다른 항목의 노드가 한 유닛에 섞였다.
- 자리가 없어야 할 노드를 묶었다: 번호 marker, 장식 글, 컴포넌트 전체 제목을 항목 필드에 묶었다.
세지 않는다: 어느 자리에도 묶이지 않은 노드(P2 몫), 위성 자리(title, subtitle, desc 위성)에 둔 노드, 표, 차트의 칸 지도(P4 몫).
입력 자료
origin_marked frame_tree_plain frame_iis spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 slot_map_node_match_bound
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 판정 제외

한계

  • O 2,000 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
  • 관문(25 문서 3절): 고치기 전까지 판정에서 뺀다(14 결정 4)

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다)
53 문서 근거
① 규약 위반 · 53 목표(제안) 2–3%
신뢰도 표지
라벨 없음
25 문서 판정
판정 제외
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 23.7% [21.8–25.8] 412/1,738
표본 250 운영 조건
20.1% [18.2–22.2] 324/1,610
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다))

출처

  • prompts/property-v8.txt:10-12(할 일 1, 구조 대응)
  • prompts/boundary-v12.4.txt:51-102(capability manifest 의 슬롯)
  • 47-decisions-1020.md 원칙, 54-index-g7-operating.md
  • 신뢰도 정답 slot_map_node_match_bound = 정답 색인 gold-iis-final-v3 의 slot_map 대비, 운영이 묶은 노드만 센다(정답에만 자리가 있는 노드는 P2 몫이라 뺀다)
spec_refs(카드 yaml)
p8-10 · b124-51
spec_refs(manifest)
p8-10 · b124-51
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/P1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
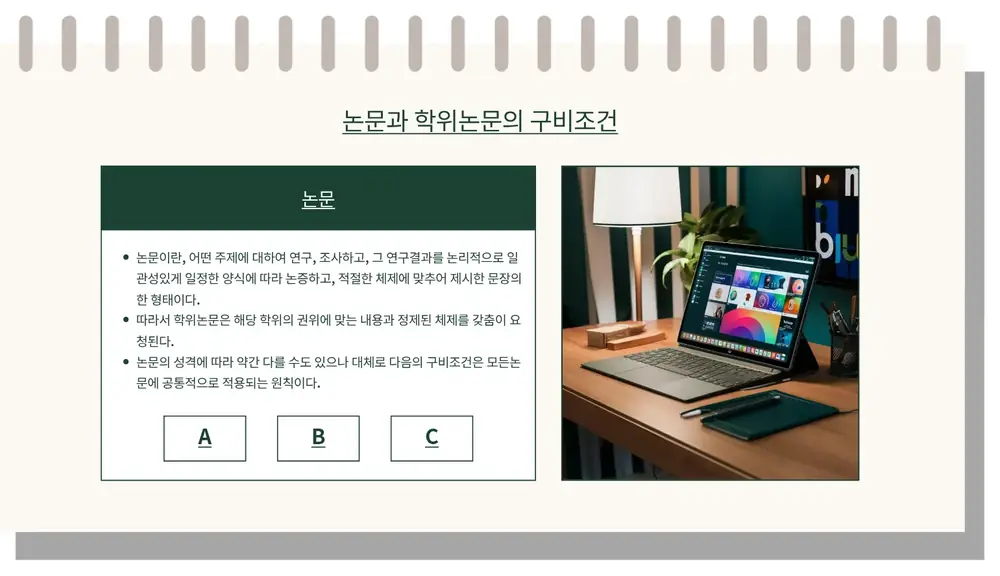
색인 · 장 단위 · 기본 m

P2 core 글이 어느 자리에도 묶이지 않음

준수 1.08% [0.97–1.21] 장

무엇

이름
core 글이 어느 자리에도 묶이지 않음
링크
색인
단위(셀)
장
기본 m
기본 m 판정, 미달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier confirmed

결함 답과 등급

개수 답(묶이지 않은 노드 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 묶이지 않은 글은 자리표시가 된다(content-binding-contract)
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
미달

무엇을 잡나

경계 안 글 노드가 운영 색인의 어느 자리(유닛 필드, 위성, 표 칸, 관계)에도 참조되지 않아, 대치가 덮지 못하고 템플릿 원문이 그대로 남게 되는 일을 잡는다. 구조 대응에 참조되지 않은 글 노드는 원문이 남아 다른 사람의 문구가 섞여 나가므로 오류다(gate-33). 색인 링크의 책임이고 경계 트리와 운영 색인을 규칙으로 견주며, Marker, Decoration 같은 비본문 role 과 구조 토큰은 원문 보존이 맞아 세지 않는다(mor2627-132, P2 v4). 대치가 받은 목록을 안 덮은 것은 D6, 결과에 보이는 잔존은 E3 몫이다.

어떻게

질문

경계 안(frame_tree)의 글 노드(type Text, 글이 비지 않은 것) 가운데 운영 색인(frame_iis)의 어느 자리에도 참조되지 않은 노드 수를 센다.
참조된 자리 = frame_iis 의 유닛 필드 노드, dataset 칸 노드(표 자리 grid 노드가 있으면 그 노드 아래 글 전부), relations 의 노드, satellites 의 title, subtitle, desc 노드(sheetId).
frame_tree 의 bound_field 는 이 질의가 쓴 필드일 뿐이다. bound_field 가 null 이어도 frame_iis 에 자리가 있으면 묶인 것이다.
세지 않는 것: role 이 Marker, Decoration, Separator, Annotation 인 노드. 구조 토큰(숫자가 아닌 한 글자 A, B, F, Q 와 VS, TAM/SAM/SOM 같은 장식 글자). 경계 안에 type Table 이나 Chart 노드가 있거나 frame_iis 의 dataset 이 matrix 면 role Title, Subtitle, Legend 글(차트 제목, 부제, 범례). categories 에 Unclassified 가 있으면 role Title, Subtitle 글(column 로컬 제목).
답은 남은 노드 수다. 하나도 없으면 0.
입력 자료
frame_tree frame_iis result_meta spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 unbound_core_text_count
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 1 (규칙 대조)
정밀도
0.25
재현율
1.00
F1
0.40
반복 일치(3회 최빈 비율)
0.99
규칙 대조 일치
0.98 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
1.08% × 0.25 ÷ 1.00 = 0.27%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

1.08% [0.97–1.21]

308/28,457 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
정답 조건 a1 3.46% [1.77–6.68] 8/231(표본 250)
측정값 [95%]
1.08% [0.97–1.21] · 308/28,457 장
보정값
—
판정
준수 목표 0 · 바닥 = 정답 조건 a1. 2,000 운영 하한 0.97% 대 바닥 상한 6.68%: 바닥 이하이거나 겹친다
기준값 대조
같은 판(표본 250) 안에서 O 3.18% [2.61–3.87] 대 바닥 상한 6.68%: 겹친다
기준값 대조
카드 판 250→2,000 = 3→4(17 문서 3.4). 정답 조건 값은 옛 판 값이다
53 문서 근거
① 규약 위반 · 53 목표(제안) 0–1%
신뢰도 표지
규칙 대조 200 · 정밀도 0.25 · 반복 0.99
25 문서 판정
확정
쉬운 / 어려운 조건
0.8% / 2.2%
찾기 차이 / 확인 차이
+1.3 [0.7–1.9] / +1.4 [0.8–2.2]
목표(제안) · 근거
0.82–0.94% · 쉬운 조건(I-f)
규약 참고(53)
0–1%
도달 · 거리
미달 · +0.14%p
정답 조건 값(표본 250 export)
조건 a 3.91% [2.07–7.27] 9/230 · 조건 a1 3.46% [1.77–6.68] 8/231
표본 250 운영 조건
3.18% [2.61–3.87] 95/2,987
답 분포(30c, 운영 조건 셀)
0: 588(98.0%), 1: 5(0.8%), 2: 1(0.2%), 3: 3(0.5%), 4: 3(0.5%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-f 순번 표식 없음 대 순번 표식(Marker) 있음0.82% 186/22,7842.15% 122/5,673순번 표식을 내용 필드와 가르지 못하면 글이 자리 없이 남는다(05 문서 2.1)
I-p1 격자(Table, Chart) 노드 있음 대 격자 노드 없음0.00% 0/3,8071.25% 308/24,650격자 안 글이 P2 셈에 들지 않는 것으로 보인다(제안, 규칙 `unbound_core_text_count.py` 확인 필요)

채택 연결

자료 없음

사례

P2 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 List · 단위 240a2c6f16a4fe01219476c268b54ab8#0#r2

P2 사례 결과 그림
결과

규칙 판정 결함 · 순위 3 · 유형 List · 단위 0de5bda6edc6ca1a36554c8591a488f2#0#r3

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • design/content-binding-contract.md(묶이지 않은 글은 자리표시로 바뀜)
  • 19-index-cards.md §0.4(boundary 와 property 사이 빈틈)
spec_refs(카드 yaml)
gate-33 · b124-22 · b124-50
spec_refs(manifest)
gate-33 · b124-22 · b124-50
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/P2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
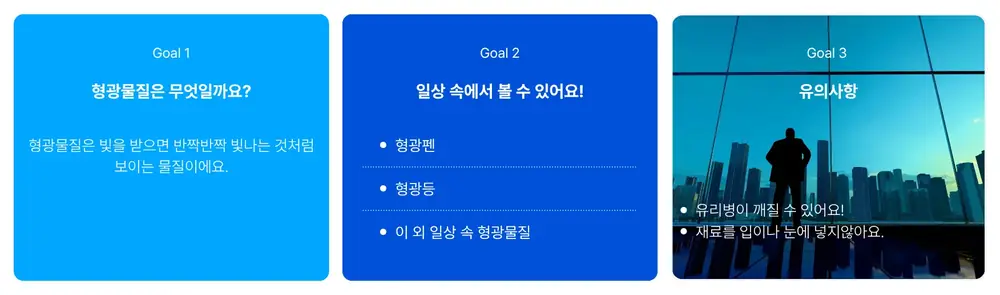
색인 · 장 단위 · 기본 m

P3 표, 차트 카테고리와 격자 요소가 어긋남

준수 0.00% [0.00–0.01] 장

무엇

이름
표, 차트 카테고리와 격자 요소가 어긋남
링크
색인
단위(셀)
장
기본 m
기본 m 판정, 도달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
ok맞음(둘 다 있거나 둘 다 없음)
no_element표, 차트 종인데 격자 요소 없음결함
no_category격자 요소가 있는데 표, 차트 종이 아님결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① capability manifest(boundary-v12.4:51–102)
주 근거
① 규약 위반
53 목표(제안)
0%
53 달성
달성

무엇을 잡나

카테고리는 dataset 이 필수인 표, 차트 종인데 격자 요소(Table, Chart 노드나 matrix 칸 지도)가 없거나, 격자 요소는 있는데 카테고리가 표, 차트 종이 아닌 어긋남을 잡는다. 표, 차트 종인데 격자가 없으면 칸 대치가 불가능하다(b124-51 의 D=matrix!, p8-20, 기본품질 13 1.1). 색인 링크의 책임이고 카테고리와 격자 요소를 규칙으로 맞댄다. 칸 지도가 원본 표와 맞는지는 P4, 카테고리 자체의 적합은 B2 몫이다.

어떻게

질문

둘을 따로 확인한 뒤 맞댄다.
(1) 카테고리: result_meta.categories 에 dataset 이 필수(D=matrix!)인 표, 차트 종이 하나라도 있는가. 그 종은 다음 16 종뿐이다: Enumeration_ListingTable, AttributeComparison_ComparisonTable, AttributeComparison_RadarChart, RelationalComparison_Quadrant, RelationalComparison_BubbleChart, TimelineSchedule_GanttChart, TimelineSchedule_Calendar, MagnitudeRanking_BarChart, ProportionComposition_StackedBarChart, ProportionComposition_PieChart, ProportionComposition_DonutChart, ProportionComposition_TreeMap, ProportionComposition_PictogramChart, Trend_LineAreaChart, Trend_ComboChart, KPIKeyMetric_Gauge.
(2) 격자 요소: frame_tree 에 type 이 Table 또는 Chart 인 노드가 있거나, frame_iis 의 dataset 이 matrix(칸 지도 또는 표 자리 grid)인가. type 이 SVG, Image 인 그림은 격자 요소가 아니다.
답: (1)과 (2)가 둘 다 있거나 둘 다 없으면 ok. (1)만 있으면 no_element. (2)만 있으면 no_category.
Enumeration_List, ProcessFlow_Steps 처럼 16 종이 아니면서 격자 요소도 없는 것은 ok 다. 「표, 차트 종이 아니다」는 no_category 의 근거가 아니다.
입력 자료
result_meta frame_tree frame_iis spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 grid_category_consistency
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 0 (규칙 대조)
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
1.00
규칙 대조 일치
1.00 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

0.00% [0.00–0.01]

0/28,457 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
정답 조건 a1 0.00% [0.00–1.64] 0/231(표본 250)
측정값 [95%]
0.00% [0.00–0.01] · 0/28,457 장
보정값
—
판정
준수 목표 0 · 바닥 = 정답 조건 a1. 2,000 운영 하한 0.00% 대 바닥 상한 1.64%: 바닥 이하이거나 겹친다
기준값 대조
같은 판(표본 250) 안에서 O 0.00% [0.00–0.13] 대 바닥 상한 1.64%: 겹친다
53 문서 근거
① 규약 위반 · 53 목표(제안) 0%
신뢰도 표지
규칙 대조 200 · 양성 0 · 반복 1.00
25 문서 판정
확정
쉬운 / 어려운 조건
0.0% / 0.0%
찾기 차이 / 확인 차이
+0.0 [0.0–0.0] / +0.0 [0.0–0.0]
목표(제안) · 근거
0% · 규약(정의상 0)
규약 참고(53)
0%
도달 · 거리
도달 · +0.00%p
정답 조건 값(표본 250 export)
조건 a 0.00% [0.00–1.64] 0/230 · 조건 a1 0.00% [0.00–1.64] 0/231
표본 250 운영 조건
0.00% [0.00–0.13] 0/2,987
답 분포(30c, 운영 조건 셀)
ok: 808(100.0%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (결함 단위 0)

출처

  • prompts/boundary-v12.4.txt:51-102(capability manifest, D=matrix! 종)
  • prompts/property-v8.txt:20-26(할 일 4)
spec_refs(카드 yaml)
p8-20
spec_refs(manifest)
p8-20
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/P3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

P4 dataset 칸 지도가 원본 구조에 맞지 않음

보류 운영 조건 값 없음

무엇

이름
dataset 칸 지도가 원본 구조에 맞지 않음
링크
색인
단위(셀)
장
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
fit맞음
transposed전치됨결함
different다름결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 칸 지도는 원본 표의 행과 열에 대응한다(property v8 할 일 4). 색인 LLM 폭
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

운영 색인의 칸 지도가 원본 표나 차트의 행과 열에 대응하지 않는 일, 곧 행과 열이 뒤바뀌거나, 행이나 열이 빠지거나 합쳐지거나, 칸 노드가 다른 칸 자리에 들어간 일을 잡는다. 칸 지도가 어긋나면 표, 차트 값이 다른 칸에 들어간다(p8-20, 기본품질 13 1.1). 색인 링크의 책임이고 원본 그림과 경계 트리로 판단하며, 신뢰도는 합성 결함으로 잰다(기본품질 14 Q16). 생성 dataset 의 모양은 G5, 대치 결과의 칸 값은 D7 몫이다.

어떻게

질문

운영 색인의 칸 지도(frame_iis 의 dataset: 행마다 칸 노드, 또는 표 자리 grid 노드 하나)가 원본 표나 차트(그림의 빨간 상자 안, 상자가 없으면 DO 전체)의 구조에 맞는가. 원본 그림과 경계 트리(frame_tree_plain)만 보고 판단한다.
- fit: 원본 표의 행과 열(차트면 항목과 계열)이 칸 지도의 행과 열에 그대로 대응한다. 머리글 행이나 열이 있으면 맨 윗 행, 맨 왼쪽 열에 있다. 경계 안에 type Table 이나 Chart 노드가 있어 grid 노드 하나만 적은 것도 fit 이다.
- transposed: 행과 열이 뒤바뀌었다(원본의 행이 칸 지도의 열로).
- different: 행이나 열을 빠뜨리거나 합쳤거나, 칸 노드가 다른 칸 자리에 들어갔거나, 원본에 표나 차트 구조가 있는데 칸 지도가 없다.
입력 자료
origin_marked frame_tree_plain frame_iis spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 dataset_map_match
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다)
53 문서 근거
① 규약 위반 · 53 목표(제안) 2–3%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 11.7% [8.7–15.5] 40/342
표본 250 운영 조건
5.83% [2.9–11.6] 7/120
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다))

출처

  • prompts/property-v8.txt:20-26(할 일 4, dataset 자리)
  • 47-decisions-1020.md 원칙, 54-index-g7-operating.md
  • 신뢰도 정답 = 합성 결함(synth/P4.py, 14 문서 Q16). 규칙 dataset_map_match(정답 색인 gold-iis-final-v3 의 cell_map 대비)는 합성 변형의 기대 라벨 대조에 쓴다
spec_refs(카드 yaml)
p8-20
spec_refs(manifest)
p8-20
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/P4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
색인 · 장 단위 · 기본 m

P5 params 가 원본 컴포넌트에 맞지 않음

보류 운영 조건 값 없음

무엇

이름
params 가 원본 컴포넌트에 맞지 않음
링크
색인
단위(셀)
장
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

개수 답(맞지 않는 키 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① params 값은 원본 근거를 따른다(property v8 반드시 지킬 것 3, 4). 색인 LLM 폭
주 근거
① 규약 위반
53 목표(제안)
2–3%
53 달성
미달(잠정)

무엇을 잡나

운영 색인 params 가 원본 그림과 어긋나는 일(세로 막대인데 가로, 시간 순인데 값 순, 오르는 계단인데 아래 방향)과 그림에 근거 없는 값을 지어낸 일을 잡는다. 색인 params 가 그림과 어긋나면 검색이 정렬, 방향이 다른 컴포넌트를 맞다고 본다(기본품질 13 1.1). 색인 링크의 책임이고 원본 그림과 경계 트리로 판단하며, 근거를 다 본 뒤에도 확정하지 못하면 생략하는 것이 색인 규약이라 생략은 세지 않는다(p8-34). 생성 params 는 G6 몫이다.

어떻게

질문

운영 색인 params(frame_iis 의 params) 의 값 가운데 원본 컴포넌트(그림의 빨간 상자 안, 상자가 없으면 DO 전체)에 맞지 않는 키가 몇 개인가. 원본 그림과 경계 트리만 보고 판단한다.
센다: 그림과 어긋난 값(세로로 늘어선 막대인데 orientation 이 가로, 시간 순서인데 sort 가 값 순, 가운데 원이 없는데 centerLabel, 위로 오르는 계단인데 direction 이 아래, 머리글 행이 없는데 header 가 있음), 그림에 근거가 없는 값을 지어낸 키.
세지 않는다: params 를 생략한 것(근거를 다 본 뒤 확정하지 못하면 생략이 허용이다), 정의 밖 이름이나 허용 밖 값 같은 형식 문제(검증기 몫), 그림만으로 맞는지 가릴 수 없는 값.
입력 자료
origin_marked frame_tree_plain frame_iis spec_excerpt
측정기
LLM
정답 종류
rule · 규칙 iis_params_key_diff_count
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
자료 없음
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다)
53 문서 근거
① 규약 위반 · 53 목표(제안) 2–3%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 gold_set 13.1% [11.6–14.7] 227/1,738
표본 250 운영 조건
10.1% [8.7–11.6] 162/1,610
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(색인 LLM 카드. 다른 export(색인 경계, idxop)에서 돈다))

출처

  • prompts/property-v8.txt:34-47(반드시 지킬 것 3, 4)
  • spec param-spec
  • 47-decisions-1020.md 원칙, 54-index-g7-operating.md
  • 신뢰도 정답 iis_params_key_diff_count = 정답 색인 params 대비(정답 params 가 운영 색인에서 파생돼 지금은 양성 0)
spec_refs(카드 yaml)
p8-34 · p8-40 · param-spec
spec_refs(manifest)
p8-34 · p8-40 · param-spec
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/P5.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 상위 10 단위 · 기본 m

R1 원본 짝이 검색에서 걸러지거나 상위 10 밖으로 밀림

띠 운영 조건 값 없음

무엇

이름
원본 짝이 검색에서 걸러지거나 상위 10 밖으로 밀림
링크
검색
단위(셀)
상위 10
기본 m
기본 m 정답 기준 띠(도달 계산 밖)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
in_top10상위 10 에 듦
capacity_c1용량으로 걸러짐(C1 몫)
filtered걸러짐결함
cost_outcost 로 밀려남결함

기본 m 근거(53 문서)

절
2 정답 기준 정상 작동 띠(근거 열 없음)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
0–2%
53 달성
미달

무엇을 잡나

정답 YAML 과 그 원본 컴포넌트의 정답 색인 행을 한 쌍으로 지금 검색 로직에 넣었을 때, 원본이 용량 밖 사유로 걸러지거나 cost 가 커서 상위 10 밖으로 밀리는 일을 잡는다. 「맞는 컴포넌트를 찾아 오는가」를 재는 유일한 검색 카드이고 운영 결과만으로는 빠진 것이 보이지 않아, 정답 조건에서 재는 「정답 기준」 띠 카드다(평가틀 47 결정 4, 6). 검색 링크의 책임이고 비교 대상은 그 정답 YAML 의 실제 검색 상위 10 의 10위 cost 다(평가틀 47 결정 7). 용량 사유로 걸러진 것은 색인 용량 추정(C1) 몫이라 결함에서 뺀다(같은 결정).

어떻게

질문

정답 YAML 과 그 원본 컴포넌트의 정답 색인 행을 한 쌍으로 지금 검색 로직에 넣으면, 원본이 상위 10 에 들어올 수 있는가.
- in_top10: 하드 필터와 순위 평가를 통과하고, 짝 cost 가 이 정답 YAML 의 실제 검색 상위 10 의 10위 cost 이하다(상위 후보가 10 개 미만이면 밀려날 자리가 없다).
- capacity_c1: 용량 사유(하드 필터 cap_min, 순위 평가 배제 Capacity, Table)로 걸러졌다. 색인 용량 추정(C1) 몫이라 결함이 아니다.
- filtered: 용량 밖 사유(카테고리, nested, 항목 수, dataset, 모양, Param, Content)로 걸러졌다.
- cost_out: 통과했지만 짝 cost 가 10위 cost 보다 커서 상위 10 에서 밀려난다.
입력 자료
gold_yaml gold_iis topk_thumbs
측정기
규칙
정답 종류
rule · 규칙 origin_pair_search_check
비교 기준
정답 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
rule_extra = origin_pair_search_reasons, 집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 띠

한계

  • O 2,000 값 없음: 정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)
  • 관문(25 문서 3절): 정답 기준 띠(운영 도달 계산 밖, 47 결정 6)

결과

자료 없음

기준값과 판정(6장 보드)

판정
띠 정답 기준 띠 = 측정기 바닥. 운영 판정 대상이 아니다(53 문서 2절)
25 문서 판정
띠
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
0–2% · 규약
규약 참고(53)
0–2%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 a1 35.2% [32.9–37.4] 608/1,729
표본 250 운영 조건
자료 없음
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)))

출처

  • 47-decisions-1020.md 결정 7(R1 변환)
  • 50-search-operating-feasibility.md 1.4절(s1-harness), 4.1절(예외 조건)
  • tools/iui-826cda2e3/rust/comp-pass/crates/s1-harness/src/main.rs(하드 필터, 순위 평가 배제, 직접 짝)
  • variants/cond_c(정답 색인 행을 덮어쓴 스냅샷 cond_c.jsonl.zst, 요청 s1/harness-requests.jsonl)
  • export a1 순위 1 행의 candidates(10위 cost)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 장 단위 · 기본 m

R2 검색 필터가 담을 수 있는 후보를 용량 때문에 거름

보류 운영 조건 값 없음

무엇

이름
검색 필터가 담을 수 있는 후보를 용량 때문에 거름
링크
검색
단위(셀)
장
기본 m
기본 m 2,000 셀 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
fits담을 수 있었음(부당한 거름)결함
overflows넘침(타당한 거름)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ④ 보조. 0.7 배 축소로 들어가는 후보는 걸러서는 안 된다(축소 하한 0.7 은 47 문서 결정 5). 들어가는지는 그림 눈대중이라 여유
주 근거
① 규약 위반
53 목표(제안)
5–10%
53 달성
미달

무엇을 잡나

검색이 용량 때문에 거른 후보가 실제로는 질의를 담을 수 있었던 일, 곧 글자를 0.7 배까지 줄이면 모든 자리에 읽히게 들어가는데 걸러진 일을 잡는다. 담을 수 있는 후보를 거르면 맞는 컴포넌트를 놓치고, 0.7 은 렌더러 축소 하한과 같은 값이다(평가틀 47 결정 4, 5, 기본품질 13 1.1). 검색 필터 코드의 책임이고 걸러진 후보의 자리 크기, 템플릿 글과 질의 글을 견주며, 원본 글이 이미 자기 용량을 넘는 후보는 색인 몫(C1)이라 뺀다(R2 v3, v4). 후보 유형의 적합은 R5, 실제로 대치된 장의 글자 크기는 T3 몫이다(기본품질 19 4절).

어떻게

질문

검색이 이 후보(그림의 빨간 상자 안 컴포넌트, 상자가 없으면 그림 전체)를 용량 때문에 걸렀다. 사유는 capacity_filter 의 reason 이다. 질의는 query_yaml 이고, capacity_filter.binding 이 이 후보의 자리마다 넣으려던 질의 글이다. capacity_filter.overflow_slots 는 검색이 넘친다고 본 자리(field, 넣으려던 query_text, 원래 템플릿 글 template_text, 글자 용량 cap_chars, 줄 수 cap_lines, 줄당 글자 cap_chars_per_line, 자리 상자 크기 box_px, 글자 크기 font_px)다.
묻는 것: 이 후보는 실제로는 질의를 담을 수 있었는가? 질의 글을 각 자리에 넣었을 때 원래 글자 크기에서, 또는 글자를 0.7 배까지 줄이면 자리 상자 안에 읽히게 들어가는가를 그림의 자리 크기와 템플릿 글의 길이에 견주어 판단한다. 템플릿 글보다 조금 긴 글은 줄바꿈이나 약간의 축소로 들어갈 수 있다. 자리 상자 크기에 비해 질의 글이 몇 배 길면 넘친다.
- fits: 질의 글이 모든 자리에 0.7 배 이상의 글자 크기로 읽히게 들어간다. 걸러진 것이 부당하다.
- overflows: 적어도 한 자리에서 0.7 배로 줄여도 상자를 넘치거나 읽기 어렵다. 걸러진 것이 맞다.
보지 않는 것: 이 후보의 유형이 질의에 어울리는지(R5 몫), 비거나 남는 자리(대치 몫), 디자인과 색, 그림 속 글이 흐리게 보이는 것(썸네일 화질).
입력 자료
source_text query_yaml capacity_filter result_thumb
측정기
LLM
정답 종류
none
비교 기준
유저 원문 (입력 이름으로 나눔)
범위
r1
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
none
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 측정 중

한계

  • O 2,000 값 없음: 입력 capacity_filter 가 하네스 판 산출이다(2.7절). 운영 판 값은 다른 export(r2op)
  • 관문(25 문서 3절): 2,000 셀 없음

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
운영 값 없음 입력 capacity_filter 가 하네스 판 산출이다(2.7절). 운영 판 값은 다른 export(r2op)
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 입력 capacity_filter 가 하네스 판 산출이다(2.7절). 운영 판 값은 다른 export(r2op))
53 문서 근거
① 규약 위반 · 53 목표(제안) 5–10%
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
5–10% · 규약
규약 참고(53)
5–10%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
30.4% [27.1–33.9] 211/695
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(입력 capacity_filter 가 하네스 판 산출이다(2.7절). 운영 판 값은 다른 export(r2op)))

출처

  • 47-decisions-1020.md 결정 4(R2 운영 측정, 용량 계열 사유만, C1 몫 제외)
  • 50-search-operating-feasibility.md 2.2(하네스로 걸러진 후보 받기, 원본 썸네일, 층 분리), 3절 R2 대안 질문
  • 20-search-cards.md §0.1(하드 필터 cap_min, 용량 게이트)
  • tools/eval/r2op_build.py(단위 만들기), eval/r2op/(하네스 입출력, 표본)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 짝 단위 · 기본 m 밖

R3 1위가 원본보다 질의에 덜 맞음

보드 밖 운영 조건 값 없음

무엇

이름
1위가 원본보다 질의에 덜 맞음
링크
검색
단위(셀)
짝
기본 m
목록에 없음 basic_m.yaml 두 목록 어디에도 없음
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status retired · tier measuring

결함 답과 등급

답뜻결함등급
first1위
similar비슷
second원본결함

기본 m 근거(53 문서)

절
4 46 초안 대비 바뀐 점(제외)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
자료 없음
53 달성
자료 없음

무엇을 잡나

퇴역 카드다. 운영판이 R6 의 질의 단위 묶음과 같고 정답 조건 예외에 해당하지 않아 보드와 운영 도달 계산에서 뺐다(평가틀 47 결정 4).

어떻게

질문

질의를 담기에 원본 W 와 1위 컴포넌트 가운데 어느 쪽이 더 맞는가?
입력 자료
gold_yaml origin_thumb result_thumb spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
정답 (입력 이름으로 나눔)
범위
gold_set
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
자료 없음

한계

  • O 2,000 값 없음: 보드에서 내림(retired)

결과

자료 없음

기준값과 판정(6장 보드)

보드 밖 카드다.

25 문서 판정
자료 없음
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 a1 8.57% [4.0–17.5] 6/70
표본 250 운영 조건
자료 없음
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(보드에서 내림(retired)))

출처

  • plan/l1-l2-result-display-blueprint.md:66-69(정렬 키 온전, tier, cost)
spec_refs(카드 yaml)
l1l2-66
spec_refs(manifest)
l1l2-66
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 장 단위 · 기본 m

R4 온전하지 않은 컴포넌트를 제공

전달 저하 준수 판정 없음 0.79% [0.70–0.90] 장

무엇

이름
온전하지 않은 컴포넌트를 제공
링크
검색
단위(셀)
장
기본 m
기본 m 판정, 도달
등급
전달 저하
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
exact딱 맞음
leftover자리 남음(유닛 필드 노드가 질의 글을 못 받음)결함전달 저하
short자리 모자람(items 자리 여럿인 유닛에서 항목이 불릿으로 합쳐짐)결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ② 보조. 온전 후보 우선(capability-table:454, blueprint:66). 공급 부족은 이미 뺐다(40 문서 6절)
주 근거
① 규약 위반
53 목표(제안)
0–2%
53 달성
미달

무엇을 잡나

검색이 질의 몫을 넣었을 때 자리가 남거나(유닛 필드가 질의 글을 못 받아 임시 문구가 됨) 모자라는(items 자리보다 항목이 많아 마지막 자리에 불릿으로 이어 붙음) 후보를 내놓는 일을 잡는다. 질의 트리 전체를 담은 온전한 후보를 앞에 두는 것이 검색 규약이다(cap-454, l1l2-66). 검색 링크의 책임이고 비교 대상은 유저 원문이 아니라 이 장의 YAML 몫이며(유저 결정 10/23), 풀에 온전한 후보가 없었던 공급 부족은 결함이 아니라 아래 순위의 온전한 후보를 놓친 것만 센다(평가틀 40 Q7, 기본품질 14 Q7). 표 칸 값은 D7, 경계 안 잔여는 P2, 경계 밖은 R8 몫이다.

어떻게

질문

이 컴포넌트가 맡은 질의 몫을 넣었을 때 남는 자리나 모자라는 자리가 있는가.
- 질의 몫 = binding 에 든 글이 나온 entity 들과 그 entity 의 필드. page_yaml 이 이 장을 만드는 데 들어간 YAML 몫(컴포넌트 하나, 나눠 담기면 이 장이 가져간 항목만)이고 그것이 질의다. page_yaml 에 없는 entity 는 형제 컴포넌트나 나눠 담기의 다른 쪽 몫이라 세지 않는다. 질의 항목 수가 유닛 수보다 많다는 이유로 short 를 내지 않는다.
- 자리 = frame_iis 의 유닛 필드 노드(label, items, value, period 등). binding 은 어느 노드에 무엇이 들어갔는지다. 자리 수와 binding 을 맞대어 판정하고 그림은 확인용이다.
- exact: marker 가 아닌 유닛 필드 노드가 모두 binding 에 있고, items 자리가 둘 이상인 유닛에서 항목이 자리마다 하나씩 들어갔다.
- leftover: marker 가 아닌 유닛 필드 노드 가운데 binding 에 없는 것이 있다(그 자리는 임시 문구가 된다). 질의가 안 쓴 period 자리는 원문이 남는 자리라 세지 않는다.
- short: 한 유닛의 items 자리가 둘 이상인데 항목이 자리 수보다 많아 마지막 자리에 「* 」 불릿으로 이어 붙었다. items 자리가 하나뿐인 유닛에 항목 여럿이 불릿으로 들어간 것은 short 가 아니다.
- 세지 않는 것: 위성 자리(satellites 의 title, subtitle, desc), 표 자리(dataset 의 칸과 grid. 남는 칸이 빈 글인 것은 허용이고 칸 값은 D7 몫), 경계 밖 요소(차트, 그림, 다른 카드, 페이지 제목), 자리 없는 필드가 label 이나 items 에 「이름: 값」이나 불릿으로 붙은 것, 값과 단위가 한 글로 합쳐진 것.
- result_thumb 는 페이지 전체라 경계 밖이 함께 보인다. 그것은 이 컴포넌트의 자리가 아니다.
입력 자료
page_yaml frame_iis binding result_thumb spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 predicted_defects_clean
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
rule_extra = clean_in_pool_but_unclean, rule_exempt_extra = ['supply'], 집계 = ratio
카드 버전
v6

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 25 (규칙 대조)
정밀도
0.87
재현율
0.52
F1
0.65
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
0.93 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
0.79% × 0.87 ÷ 0.52 = 1.32%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.2: 규칙

결과

0.79% [0.70–0.90]

226/28,457 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

행 1/2

등급
전달 저하 결함 답 short
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 규칙
측정값 [95%]
1.17% [1.05–1.30] · 333/28,457 장
보정값
—
판정
준수
신뢰도 표지
규칙 대조 200 · 정밀도 0.87 · 반복 0.98

행 2/2

등급
전달 저하 결함 답 leftover
목표 수준
원본 수준
기준값과 출처
4절 행 없음 30 문서 4절 표에 이 결함 답의 행이 없다
측정값 [95%]
7.05% [6.76–7.35] · 2,006/28,457 장
보정값
—
판정
판정 없음 30 문서 4절 표에 판정 행 없음(8절 1 로 마감 미흡에서 전달 저하로 옮긴 결함 답)
신뢰도 표지
규칙 대조 200 · 정밀도 0.87 · 반복 0.98
25 문서 판정
확정
쉬운 / 어려운 조건
0.7% / 1.6%
찾기 차이 / 확인 차이
+0.4 [-0.4–1.3] / +1.5 [0.3–3.0]
목표(제안) · 근거
0.69–0.80% · 쉬운 조건(잠정)(S-a)
규약 참고(53)
0–2%
도달 · 거리
도달 · -0.01%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
8.00% [7.08–9.03] 239/2,987
답 분포(30c, 운영 조건 셀)
exact: 547(91.2%), leftover: 52(8.7%), short: 1(0.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
K 나눠 담기 장 대 나눠 담기 아님0.30% 34/11,1661.11% 192/17,291나눠 담기는 쪽마다 자리 수에 맞춰 항목을 나눈다(iui 설계 `content-threading-design.md`)
M-table 장 범위 표 나눠 담기 대 장 범위 표 나눠 담기 밖0.00% 0/3,5690.92% 226/24,699표 장은 행을 칸 수에 맞춰 담고, R4 의 자리 셈이 격자를 보지 않는 것으로 보인다(제안)

채택 연결

자료 없음

사례

R4 사례 결과 그림
결과

규칙 판정 결함 · 순위 6 · 유형 List · 단위 05127915414434f357eccb5f7a7de198#0#r6

R4 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 List · 단위 ca5709d451a3180e21792f054763b2e4#0#r2

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • spec/capability-table.md:454(N1 질의 트리 전체를 담은 후보)
  • plan/l1-l2-result-display-blueprint.md:66(온전 우선, above_tier)
  • iui rust/comp-pass/crates/comp-frame-core/src/align.rs place_same_fields(itemOverflow 는 many 필드의 초과 항목 수)
  • iui rust/comp-pass/crates/comp-frame-core/src/rank.rs unauthored_count_of(빈 자리 + 경계 안 잔여 + 경계 밖 글). 규칙은 이 수를 읽지 않는다(경계 안 잔여는 P2, 경계 밖은 R8 몫)
spec_refs(카드 yaml)
cap-454 · l1l2-66
spec_refs(manifest)
cap-454 · l1l2-66
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 장 단위 · 기본 m 밖

R5 질의 유형과 무관한 표현을 제공

준수 0.00% [0.00–0.01] 장

무엇

이름
질의 유형과 무관한 표현을 제공
링크
검색
단위(셀)
장
기본 m
기본 m 밖 감시 카드(14 문서 Q15, 유저 결정 10/24)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status ref · tier confirmed

결함 답과 등급

답뜻결함등급
type유형
fallback허용 대체
unrelated무관결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① fallback 행(schema-v0.5:149, 692)
주 근거
① 규약 위반
53 목표(제안)
0%
53 달성
달성

무엇을 잡나

검색이 질의 type 과도, 그 type 의 fallback 행과도 무관한 카테고리의 컴포넌트를 내놓는 일을 잡는다. 검색은 type 을 따를 의무는 없지만 그 type 의 자기 fallback 행 안에서만 내려가는 것이 검색 계약이다(schema-0.5-149, schema-0.5-692, cap-169). 검색 링크의 책임이고 질의 type 은 이 장의 YAML 몫에서 읽는다(유저 결정 10/23). 운영 검색은 사다리 안에서만 골라 정의상 0 이어야 하므로, 사다리 표와 검색 코드의 어긋남을 지키는 감시 카드다. 그래서 기본 m 목록에서 뺐다(기본품질 14 Q15, 유저 결정 10/24).

어떻게

질문

이 컴포넌트의 카테고리(result_meta.categories)가 질의 type 인가, 그 type 의 fallback 행 안인가, 둘 다 아닌가.
- 질의 type = 이 장을 만드는 데 들어간 YAML 몫(page_yaml)의 컴포넌트 type. page_yaml 은 컴포넌트 하나다. fallback_row.types 는 page_yaml 의 type 과 같다. 그 type 의 행이 fallback_row.rows 에 없으면 last_resort 만 본다.
- 이름은 점과 밑줄만 다르다. ProcessFlow.Steps 와 ProcessFlow_Steps 는 같은 type 이다.
- type: categories 가운데 하나라도 질의 type 과 같다.
- fallback: type 은 아니지만 categories 가운데 하나라도 질의 type 의 fallback 행(fallback_row.rows)이나 last_resort 에 있다.
- unrelated: 둘 다 아니다.
- 운영 검색은 질의 type 의 fallback 사다리 안에서만 후보를 고르므로 unrelated 는 사다리 표와 검색 코드가 어긋날 때만 나온다. 이 카드는 그 어긋남을 지키는 감시 카드다.
- 판정은 categories 와 fallback_row 로 한다. categories 에 질의 type 이 있으면 그림이 다른 표현처럼 보여도 type 이다. 그림은 categories 가 비었을 때만 표현을 읽는 데 쓴다.
입력 자료
page_yaml binding result_thumb result_meta fallback_row spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 category_in_fallback_row
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
rule_extra = tier1_available_and_fallback, 집계 = ratio
카드 버전
v4

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 0 (규칙 대조)
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
1.00
규칙 대조 일치
1.00 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
자료 없음

한계

자료 없음

결과

0.00% [0.00–0.01]

0/28,446 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
바닥 규칙 대조 200 · 양성 0 · 대조 반복 일치 1.00 · 측정 0
측정값 [95%]
0.00% [0.00–0.01] · 0/28,446 장
보정값
—
판정
준수 목표 0 · 측정 0/28,446, 구간 상한 0.01%
53 문서 근거
① 규약 위반 · 53 목표(제안) 0%
기본 m
기본 m 밖(basic_m.yaml not_basic_m). 판정은 내되 기본 m 집계에 넣지 않는다
신뢰도 표지
규칙 대조 200 · 양성 0 · 반복 1.00
25 문서 판정
자료 없음
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
0.00% [0.00–0.13] 0/2,987
답 분포(30c, 운영 조건 셀)
type: 583(97.2%), fallback: 17(2.8%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (결함 단위 0)

출처

  • spec/schema-v0.5.md:149
  • spec/schema-v0.5.md:692
  • design/content-binding-contract.md:293
  • spec/capability-table.md 3.2절(fallback 행)
spec_refs(카드 yaml)
schema-0.5-149 · schema-0.5-692 · contract-293 · schema-0.5-669 · schema-0.5-678 · cap-169
spec_refs(manifest)
schema-0.5-149 · schema-0.5-692 · contract-293 · schema-0.5-669 · schema-0.5-678 · cap-169
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R5.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 짝 단위 · 기본 m

R6 순위 역전

보류 13.4% [12.9–13.8] 짝

무엇

이름
순위 역전
링크
검색
단위(셀)
짝
기본 m
기본 m 측정 중(값만)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
first1위
similar비슷
secondk위결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④, ② 보조. 짝 비교는 판단이 갈린다
주 근거
④ 사람 한계
53 목표(제안)
5–10%
53 달성
미달

무엇을 잡나

1위보다 질의에 더 맞는 컴포넌트가 아래 순위(2–10위)에 있는 순위 역전을 잡는다. 질의에 더 맞는 컴포넌트를 위에 두는 것은 검색 순위의 책임이다(l1l2-66, 기본품질 13 1.1). 검색 링크의 책임이고 두 컴포넌트를 각자 자기 장의 YAML 몫에 견주어 고르며, 나눠 담기나 L2 의 다른 장으로 간 항목이 그림에 없는 것은 감점하지 않는다(유저 결정 10/23). 한 후보가 온전한지는 R4 몫이다.

어떻게

질문

1위 컴포넌트와 k위 컴포넌트 가운데 질의에 더 맞는 쪽은?(k = 2–10) 질의는 컴포넌트마다 그 장을 만드는 데 들어간 YAML 몫이다. A.page_yaml 은 A 컴포넌트의 몫, B.page_yaml 은 B 컴포넌트의 몫이다. 각 컴포넌트를 자기 몫에 견주어 얼마나 맞게 담았는지로 고른다. 나눠 담기(리스트, 표)나 L2 묶음의 다른 장으로 간 항목은 그 page_yaml 에 없으므로, 그것이 그림에 없는 것은 감점이 아니다.
입력 자료
page_yaml result_thumb spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.86
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음

결과

13.4% [12.9–13.8]

3,439/25,748 짝 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
사람 판단 갈림 수준
기준값과 출처
사람 판단 갈림 사람 직접 라벨 0 · 사람끼리 일치 값 없음
측정값 [95%]
13.4% [12.9–13.8] · 3,439/25,748 짝
보정값
—
판정
보류 (바닥 근거 없음). 사람 판단이 갈리는 수준을 잴 사람 라벨(라벨러 둘 이상)이 없다
참고
3회 반복 일치 0.86(측정기 값)
53 문서 근거
④ 사람 한계 · 53 목표(제안) 5–10%
신뢰도 표지
라벨 없음 · 반복 0.86
25 문서 판정
측정 중
쉬운 / 어려운 조건
12.8% / 17.7%
찾기 차이 / 확인 차이
+3.1 [-1.3–7.6] / +6.6 [2.4–11.3]
목표(제안) · 근거
12.81–13.25% · 쉬운 조건(잠정)(S-a)
규약 참고(53)
5–10%
도달 · 거리
(미달(구간 겹침)) · +0.11%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
13.9% [12.7–15.3] 383/2,747
답 분포(30c, 운영 조건 셀)
first: 27,720(35.9%), similar: 37,453(48.5%), second: 12,071(15.6%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
S-c 질의 dataset 있음 대 질의 dataset 없음5.54% 349/6,29515.9% 3,090/19,444dataset 질의는 kind 일치와 격자 게이트로 후보가 좁혀져 비슷한 후보끼리 다툼이 적다(05 문서 3.1 S-c 설명, 제안 해석)
D-t 제목 위성 없음(titleDropped) 대 제목 위성 있음12.1% 2,336/19,38117.3% 1,103/6,367해석 없음(제안 보류)

채택 연결

자료 없음

사례

R6 사례 1위 그림
1위
R6 사례 4위 그림
4위

모델 답 k위 · 반복 3회 중 최빈 비율 1.00 · 순위 4 · 유형 List · 단위 f43d532ec10fbca5fa74c0fb01f22a3e#0|f43d532ec10fbca5fa74c0fb01f22a3e#0#r4

모델 근거(3회 중 첫 답): B는 YAML의 8개 항목을 모두 담고 있으며, A는 제목·부제목·설명 입력 자리와 큰 앰퍼샌드가 항목 영역을 침범해 내용이 덜 온전하게 표현되었습니다.

R6 사례 1위 그림
1위
R6 사례 7위 그림
7위

모델 답 k위 · 반복 3회 중 최빈 비율 1.00 · 순위 7 · 유형 Steps · 단위 0b8ba89b3586025d2a38aa9bf6e8046e#0|0b8ba89b3586025d2a38aa9bf6e8046e#0#r7

모델 근거(3회 중 첫 답): A의 몫은 본선 난간 등에 SART를 고정하는 절차 설명인데 결과는 그 문장만 담았고, B는 전원 켜기와 거치대 고정 두 단계를 각각 세부 지침까지 충실히 담았습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • plan/l1-l2-result-display-blueprint.md:66-69(정렬 키)
spec_refs(카드 yaml)
l1l2-66 · contract-293
spec_refs(manifest)
l1l2-66 · contract-293
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R6.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 상위 10 단위 · 기본 m

R7 상위 10 안에 같은 모양 중복

보류 0.10% [0.03–0.37] 상위 10

무엇

이름
상위 10 안에 같은 모양 중복
링크
검색
단위(셀)
상위 10
기본 m
기본 m 판정, 미달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier confirmed

결함 답과 등급

개수 답(중복 컴포넌트 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 중복 제거(content-binding-contract:255, pipeline-flow:81)
주 근거
① 규약 위반
53 목표(제안)
0%
53 달성
미달

무엇을 잡나

상위 10 안에 배치와 구성이 같고 색과 장식만 다른 컴포넌트가 중복해 나오는 일을 잡는다. 후보 채점에서 같은 모양을 지문으로 걸러 내는 것이 검색 계약이다(contract-255, flow-81). 검색 링크의 책임이고 상위 10 을 frame 지문과 MOR-2690 동형 기준으로 규칙 판정하며, L2 조합과 L1 한 장은 같은 DO 를 써도 같은 모양으로 세지 않는다(기본품질 14 Q13). 상위 10 의 시각 다양성 자체는 응용 몫(R9)이다(기본품질 13 1.4).

어떻게

질문

이 상위 10 컴포넌트 가운데 서로 같은 모양(배치와 구성이 같고 색과 장식만 다름)인 컴포넌트가 있는가?
- 여러 컴포넌트를 함께 담은 결과(L2 조합)와 컴포넌트 하나를 담은 결과(L1 한 장)는 같은 컴포넌트를 써도 같은 모양이 아니다.
입력 자료
topk_thumbs spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 fingerprint_isomorphic_dup_count
비교 기준
결과 그림만 (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 1 (규칙 대조)
정밀도
0.00
재현율
0.00
F1
0.00
반복 일치(3회 최빈 비율)
0.72
규칙 대조 일치
0.40 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

0.10% [0.03–0.37]

2/1,962 상위 10 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
바닥 근거 없음 규칙 대조 200 · 양성 1 · 대조 반복 일치 0.72
측정값 [95%]
0.10% [0.03–0.37] · 2/1,962 상위 10
보정값
—
판정
보류 (바닥 근거 없음). 정답 조건 값이 없고, 규칙 대조 반복 일치 0.72 가 관문 0.8(25 문서 3절) 아래라 바닥으로 쓰지 못한다
53 문서 근거
① 규약 위반 · 53 목표(제안) 0%
신뢰도 표지
규칙 대조 200 · 정밀도 0.00 · 반복 0.72
25 문서 판정
확정
쉬운 / 어려운 조건
0.1% / 0.0%
찾기 차이 / 확인 차이
-0.1 [-0.3–0.0] / -0.1 [-0.3–0.0]
목표(제안) · 근거
0% · 규약(정의상 0)
규약 참고(53)
0%
도달 · 거리
미달 · +0.10%p
정답 조건 값(표본 250 export)
조건 a None [None] 0/0 · 조건 a1 None [None] 0/0
표본 250 운영 조건
1.06% [0.36–3.06] 3/284
답 분포(30c, 운영 조건 셀)
0: 250(41.7%), 1: 179(29.8%), 2: 84(14.0%), 3: 42(7.0%), 4: 15(2.5%), 5: 11(1.8%), 6: 5(0.8%), 7: 6(1.0%), 8: 2(0.3%), 10: 3(0.5%), 11: 1(0.2%), 12: 1(0.2%), 13: 1(0.2%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

R7 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 List · 단위 44598200ac398045a9ac8a96878fa23a#0

R7 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 List · 단위 ad3203c4aac49f8b551de691322d205a#0

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • design/content-binding-contract.md:255
  • design/pipeline-flow.md:81
  • MOR-2690 동형 기준
spec_refs(카드 yaml)
contract-255 · flow-81 · l1l2-102
spec_refs(manifest)
contract-255 · flow-81 · l1l2-102
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R7.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
검색 · 장 단위 · 기본 m

R8 경계 밖에 글이나 차트, 표를 가진 후보가 상위에 옴

보류 운영 조건 값 없음

무엇

이름
경계 밖에 글이나 차트, 표를 가진 후보가 상위에 옴
링크
검색
단위(셀)
장
기본 m
기본 m 판정 제외
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status rule · tier measuring

결함 답과 등급

답뜻결함등급
none경계 밖 요소 없음
outside_placeholder경계 밖 임시 문구(관찰)
outside_template경계 밖 템플릿 원문 글결함
outside_data경계 밖 차트, 표 데이터결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 47 문서 결정 1 이 결함으로 정했다
주 근거
자료 없음
53 목표(제안)
(0–1%)
53 달성
정할 수 없음

무엇을 잡나

부분 매치 후보의 경계 밖(같은 DO 에 함께 들어가는 나머지)에 사용자 글을 받지 못하는 차트, 표 데이터나 대치되지 않는 템플릿 글이 있어, 이 장 내용과 무관한 것이 결과에 남는 일을 잡는다. 경계 밖 데이터 요소의 책임은 검색과 대치 둘 다이고, 검색은 피할 수 있었는데 못 피한 것이 결함이다(평가틀 47 결정 1). 검색 링크의 책임이고 후보의 경계 밖 노드를 규칙으로 보며, 경계 밖 임시 문구는 관찰값이다. 유저가 받는 DO 전체에 보이는 잔존은 E3 몫이다. 지금 값은 결정 1 의 「피할 수 있었는가」 조건이 규칙에 없는 상한값이라 판정에서 뺀 상태다(기본품질 14 결정 4, 유저 결정 10/24).

어떻게

질문

이 후보는 부분 매치(경계가 DO 의 root 가 아님)이고, 경계 밖(같은 DO 에 함께 들어가는 나머지)에 사용자 글을 받지 못하는 요소가 있는가.
- outside_data: 경계 밖에 차트나 표 요소가 있어 템플릿 수치, 범례가 그대로 들어간다. 차트 노드 없이 도형으로 그린 차트(간트 막대 등)도 형제 경계의 차트 카테고리로 잡는다.
- outside_template: 경계 밖 글 노드가 대치되지 않아 템플릿 원문이 남는다.
- outside_placeholder: 위 둘은 없고 경계 밖 글이 임시 문구로 바뀐다(위성 임시 문구 포함, 관찰값).
- none: 경계 밖에 그런 요소가 없다.
규칙(outside_element_left)이 답을 정한다. LLM 을 부르지 않는다(model rule, 비용 0).
입력 자료
outside_nodes
측정기
규칙
정답 종류
rule · 규칙 outside_element_left
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
rule_extra = outside_placeholder_count, 집계 = ratio
카드 버전
v2

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 판정 제외

한계

  • O 2,000 값 없음: 고치기 전까지 판정에서 뺀다(14 문서 결정 4)
  • 관문(25 문서 3절): 고치기 전까지 판정에서 뺀다(14 결정 4)

결과

자료 없음

기준값과 판정(6장 보드)

등급
—
목표 수준
—
기준값과 출처
운영 값 없음 고치기 전까지 판정에서 뺀다(14 문서 결정 4)
측정값 [95%]
운영 값 없음
보정값
—
판정
보류 (2,000 운영 값 없음: 고치기 전까지 판정에서 뺀다(14 문서 결정 4))
53 문서 근거
정하지 못함(1.7 근거별 집계에서 빠짐) · 53 목표(제안) (0–1%)
신뢰도 표지
라벨 없음
25 문서 판정
판정 제외
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
1.67% [1.27–2.20] 50/2,987
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(고치기 전까지 판정에서 뺀다(14 문서 결정 4)))

출처

  • 37-residue-attribution.md §2.3, §2.4, §3, §6 제안 5
  • iui packages/comp-frame-client/src/replacement.ts:557-561(대치 입력 = DO sheet 전체)
  • iui packages/comp-frame-shared/src/outsideText.ts:120-145(경계 밖 목록은 글 노드만)
  • iui rust/comp-pass/crates/comp-frame-core/src/rank.rs:387-394(경계 밖 벌점은 글 노드만)
  • iui docs/superpowers/specs/2026-10-12-mor-2627-replacement-policy-design.md:460-461(차트 비우기는 정책 범위 밖)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/R8.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D1 원본 재현 실패

띠 운영 조건 값 없음

무엇

이름
원본 재현 실패
링크
대치
단위(셀)
장
기본 m
기본 m 정답 기준 띠(도달 계산 밖)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
same같음
different다름결함

기본 m 근거(53 문서)

절
2 정답 기준 정상 작동 띠(근거 열 없음)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
0%
53 달성
미달

무엇을 잡나

정답 YAML 의 글을 원본 컴포넌트에 되넣었을 때 원본이 재현되지 않는 일, 곧 글자가 원본의 0.70 배 미만으로 줄거나, 같은 형제 묶음끼리 축소 비가 다르거나, 원본 크기 고정 결과에 축소나 상자 넓힘이 있거나, 정답 글이 다른 자리에 들거나 빠진 일을 잡는다. 운영 조건 기준은 너무 가혹할 우려가 있어 원본 강제 조건으로 재는 「정답 기준」 띠 카드다(평가틀 47 결정 6, 류민). 대치 링크의 책임이고 비교 대상인 원본 DO 시트는 대치의 입력이지 정답이 아니다(평가틀 47 결정 5). 정렬 바뀜은 관찰값이고, 운영 결과 그림의 글자 크기와 위계는 T3, T6 몫이다(기본품질 19 4절).

어떻게

질문

정답 YAML 의 글을 원본 컴포넌트에 되넣은 결과(조건 w)가 허용된 조정 범위 안에서 원본을 재현했는가. 아래 가운데 하나라도 있으면 다르다.
- 글자 축소 한도: 글 노드의 렌더 글자 크기가 원본의 0.70 배 미만이다(렌더러 오토핏 한도).
- 형제 묶음 배율: 같은 형제 묶음(siblingGroups) 안 글자 축소 비가 서로 다르다(차이 0.01 초과).
- 원본 크기 고정: 나눠 담기나 original_size_verified 결과인데 글자 축소나 상자 넓힘이 있다.
- 글 자리: 정답 글이 다른 필드 자리에 들어갔거나(misplaced), 빠졌거나 묶인 노드가 비었다(W4.1–W4.3).
- 정렬 바뀜, 기준점 이탈, 한 노드 안 글자 크기 종류가 줄어든 것은 관찰값이고 결함이 아니다.
입력 자료
gold_yaml frame_tree binding node_text_map origin_thumb spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 w_format_check
비교 기준
정답 (입력 이름으로 나눔)
범위
w
집계 규칙
rule_extra = w_format_reasons, 집계 = ratio
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
- · 띠

한계

  • O 2,000 값 없음: 정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)
  • 관문(25 문서 3절): 정답 기준 띠(운영 도달 계산 밖, 47 결정 6)

결과

자료 없음

기준값과 판정(6장 보드)

판정
띠 정답 기준 띠 = 측정기 바닥. 운영 판정 대상이 아니다(53 문서 2절)
25 문서 판정
띠
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
0% · 규약
규약 참고(53)
0%
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 w 0.35% [0.12–1.01] 3/866
표본 250 운영 조건
자료 없음
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (O 2,000 셀 없음(정답 조건(gold_set, a, a1, w) 카드. O 2,000 측정 대상이 아니다(16 문서 표)))

출처

  • 21-replace-cards.md §1 D1(1단계 a→A 재현, W4.1, W4.2, W4.3)
  • tools/eval/rules/w_reproduction_check.py(W4.1 묶인 노드 빈 글, W4.2 정답 글 없음, W4.3 다른 필드)
  • 47-decisions-1020.md 결정 5, 6(안 2), 49-d1-operating.md 2절 4, 9, 5절 안 2
  • tools/eval/rules/w_format_check.py, tools/eval/build_d1_render.py(s1/payloads/W*, s1/rendered/W*, s1/replace-W.jsonl.gz)
spec_refs(카드 yaml)
mor2627-138
spec_refs(manifest)
mor2627-138
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · slot 단위 · 기본 m

D2 질의 글이 결과에 없음

전달 저하 미준수 3.56% [3.49–3.62] slot

무엇

이름
질의 글이 결과에 없음
링크
대치
단위(셀)
slot
기본 m
기본 m 판정, 미달
등급
전달 저하
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
visible보임(대상 글과 글자가 같은 노드가 있음)
merged합쳐져 보임(불릿 한 줄이 대상 글과 같음, 「이름: 값」, 부분 문자열)
title_no_slot문서 제목인데 제목 자리가 없음(binding 에 field title 없음, 결함 아님)
absent없음(위 셋이 모두 아님)결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
③ 텍스트 전량 보존(content-binding-contract 3.7.3)이 원칙이나 자리가 모자란 후보에서는 빠진다
주 근거
③ 구조 하한
53 목표(제안)
2–3%
53 달성
달성

무엇을 잡나

질의 글 하나가 대치 결과 어디에도 없는 일(같은 글로도, 불릿 한 줄이나 「이름: 값」으로도 없음)을 잡는다. 텍스트 전량 보존은 대치 계약이다(contract-601, content-binding-contract 3.7.3). 대치 링크의 책임이고 비교 대상은 질의 글이며, 나눠 담기면 같은 항목의 모든 쪽을 합쳐 찾는다(D2 v3, v5, 기본품질 18). 제목 자리가 없는 장에 문서 제목이 없는 것은 결함이 아니고(user-title-1019), 엉뚱한 자리에 든 것은 D3, 생성에서 이미 빠진 글은 G7 몫이다.

어떻게

질문

대상 질의 글(target)이 이 장의 결과 글에 있는가. 결과 글 = node_text_map_union 의 글(대치 뒤 글)과 result_thumbs_pages 에 보이는 글이다. query_yaml 에 적혀 있다는 것은 「보임」의 근거가 아니다.
- visible: 어떤 노드 글 하나가 대상 글과 같다(공백, 대소문자 차이는 같음).
  예: 대상 글과 글자가 같은 노드가 하나라도 있으면 visible 이다. 비슷한 다른 글이 함께 있어도, 그림에서 잘 안 보여도 node_text_map_union 에 같은 글이 있으면 visible 이다.
- merged: 같은 노드는 없지만 어떤 노드 글 안에 대상 글이 「* 」 불릿 한 줄로, 「이름: 값」 꼴로, 또는 부분 문자열(4자 이상)로 들어 있다.
  예: 여러 줄 노드 글의 불릿 한 줄(「* 」 뒤)이 대상 글과 같으면 merged 다(없어진 것이 아니다). 노드 글을 줄마다 나눠 모든 줄을 대상 글과 견준다.
- title_no_slot: 대상 필드가 title 인데 이 장에 제목 자리(binding 의 field title)가 없어 제목이 들어가지 않았다. 결함이 아니다(제목 자리 판정은 D4 몫).
  예: 대상 필드가 title 이고 binding 에 field title 이 하나도 없는 템플릿이면, 같거나 포함하는 글이 없을 때 absent 가 아니라 title_no_slot 이다.
- absent: 그 밖. 글이 전혀 없거나 뜻이 바뀐 다른 글만 있다. 위 세 경우를 모두 확인한 뒤에만 고른다.
나눠 담기면 node_text_map_union 은 「쪽 i/N」 별로 글을 나누어 담고 result_thumbs_pages 는 쪽 그림을 쪽 순서대로 담는다. 어느 쪽에 있든 그 전부에서 찾는다.
입력 자료
query_yaml binding node_text_map_union result_thumbs_pages spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 query_text_presence
비교 기준
질의 YAML (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v5

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 6 (규칙 대조)
정밀도
0.45
재현율
0.83
F1
0.59
반복 일치(3회 최빈 비율)
0.93
규칙 대조 일치
0.83 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
3.56% × 0.45 ÷ 0.83 = 1.94%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.2: 규칙, F1 0.59

결과

3.56% [3.49–3.62]

10,602/297,998 slot · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 규칙, F1 0.59
측정값 [95%]
3.56% [3.49–3.62] · 10,602/297,998 slot
보정값
—
판정
미준수 (장 단위)
신뢰도 표지
규칙 대조 200 · 정밀도 0.45 · 반복 0.93
25 문서 판정
확정
쉬운 / 어려운 조건
3.3% / 5.9%
찾기 차이 / 확인 차이
+3.0 [-0.2–8.9] / +2.2 [-0.1–5.6]
목표(제안) · 근거
2–3% · 규약
규약 참고(53)
2–3%
도달 · 거리
미달 · +0.56%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
1.53% [1.39–1.67] 443/29,027
답 분포(30c, 운영 조건 셀)
visible: 399(64.4%), merged: 144(23.2%), title_no_slot: 41(6.6%), absent: 36(5.8%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-a 카테고리 entity 종 대 dataset 필수, 규약 밖 종 섞임1.50% 4,045/270,50323.8% 6,557/27,495표, 차트 컴포넌트는 글 자리가 칸뿐이라 질의의 제목, 설명 글이 들어갈 자리가 없다(제안)
S-e 질의 List, Steps, QnA, 목차 대 그 밖 질의 유형1.61% 3,963/246,20112.8% 6,639/51,797나눠 담기로 원본 크기 후보를 확보한다(05 문서 3.1)

채택 연결

자료 없음

사례

D2 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 ListingTable · 단위 ca33dafd4fffd7d5fe1c8711ed3eb177#0#r2#0.items.1

D2 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 Steps · 단위 c7a3091a48b659e4e3031367d85284e3#0#0.items.2

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • design/content-binding-contract.md 3.7.3(텍스트 전량 보존)
  • 21-replace-cards.md §0.1(제목 규칙, 유저 규칙 10/19 자리가 없으면 결함 아님)
spec_refs(카드 yaml)
contract-601 · cap-286
spec_refs(manifest)
contract-601 · cap-286
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · slot 단위 · 기본 m

D3 질의 글이 다른 자리에 들어감

전달 저하 보류 1.84% [1.77–1.91] slot

무엇

이름
질의 글이 다른 자리에 들어감
링크
대치
단위(셀)
slot
기본 m
기본 m 판정, 미달
등급
전달 저하
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
right맞는 자리(binding.field 가 질의 필드와 같음)
wrong다른 자리결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① binding 필드 대응(mor-2627 설계 §3)
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
달성

무엇을 잡나

질의 글이 결과에는 있지만 다른 노릇의 자리(다른 항목의 label 이나 items, Marker 나 Decoration 같은 비본문 노드)에 들어간 일을 잡는다. 글을 binding 필드에 맞는 노릇의 자리에 넣는 것이 대치의 책임이다(mor-2627 설계 3절, cap-284). 대치 링크의 책임이고 질의 필드와 binding 필드를 규칙으로 견주며, 자리 없는 필드가 그 항목의 items 에 「이름: 값」으로 붙은 것은 맞는 자리다(cap-286). 글이 아예 없는 것은 D2, 색인 자리 지도의 오류는 P1 몫이다.

어떻게

질문

대상 질의 글(target)의 필드(title, label, items, value, period 등)와 그 글이 들어간 노드의 binding.field 가 같은 노릇인지 본다. 자리 = binding 의 field 다.
글이 든 노드 = binding 에서 text 가 대상 글을 담은 항목(같은 글, 「* 」 불릿 줄, 「이름: 값」, 부분 문자열).
- right: 질의 필드와 binding.field 가 같다(items.j 는 items). title 은 binding.field 가 title 이거나, 문서 제목과 같은 글이 entity label 로도 있어 label 자리에 들어간 경우. value, period, author, organization, source 가 그 entity 의 items 자리에 「이름: 값」으로 붙은 경우. 같은 entity 의 label 과 items 가 한 자리에 「* 」 불릿으로 합쳐진 경우.
- wrong: 다른 entity 의 자리나 다른 노릇의 자리에 들어갔다(label 글이 다른 항목의 items 자리, items 글이 다른 항목의 label 자리 등). 또는 role 이 Marker, Decoration, Separator, Annotation 인 노드에 들어갔다.
노드의 RLSC role(Title, Description, Highlight)이 질의 필드와 달라 보여도 binding.field 가 맞으면 맞는 자리다.
frame_tree 의 text 는 대치 전 템플릿 원문이다. 현재 글은 node_text_map_union(나눠 담기면 「쪽 i/N」 별)과 binding.text 다. result_thumbs_pages 는 쪽 그림 전부다. 템플릿 원문이 질의 글과 다르다는 것은 다른 자리의 근거가 아니다.
입력 자료
query_yaml binding node_text_map_union frame_tree result_thumbs_pages spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 binding_field_role_match
비교 기준
질의 YAML (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
97 · 양성 2 (규칙 대조)
정밀도
0.40
재현율
1.00
F1
0.57
반복 일치(3회 최빈 비율)
0.95
규칙 대조 일치
0.97 (97 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
1.84% × 0.40 ÷ 1.00 = 0.74%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.2: 규칙, 정밀도 0.40

결과

1.84% [1.77–1.91]

2,569/139,642 slot · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 규칙, 정밀도 0.40
측정값 [95%]
1.84% [1.77–1.91] · 2,569/139,642 slot
보정값
—
판정
보류
신뢰도 표지
규칙 대조 97 · 정밀도 0.40 · 반복 0.95
25 문서 판정
확정
쉬운 / 어려운 조건
1.9% / 1.5%
찾기 차이 / 확인 차이
-0.1 [-0.8–1.1] / -0.8 [-1.7–0.5]
목표(제안) · 근거
0–1% · 규약
규약 참고(53)
0–1%
도달 · 거리
미달 · +0.84%p
정답 조건 값(표본 250 export)
조건 a None [None] 0/0 · 조건 a1 0.00% [0.0–39.0] 0/6
표본 250 운영 조건
0.57% [0.47–0.69] 98/17,229
답 분포(30c, 운영 조건 셀)
right: 462(74.8%), wrong: 156(25.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
S-e 질의 List, Steps, QnA, 목차 대 그 밖 질의 유형0.84% 896/106,9475.12% 1,673/32,695같은 이유(05 문서 3.1)
S-b 질의 List, LongForm, Highlighted 대 그 밖 질의 유형1.04% 1,058/101,4853.96% 1,511/38,157개수 조건만 있는 종이라 필드가 단순하다(05 문서 3.1)

채택 연결

자료 없음

사례

D3 사례 결과 그림
결과

규칙 판정 결함 · 순위 10 · 유형 ListingTable · 단위 aa31dff3a0e845f5d0bc564539a23538#0#r10#1.label

D3 사례 결과 그림
결과

규칙 판정 결함 · 순위 5 · 유형 List · 단위 b701da5ed26432b27431f107b71ac571#0#r5#t.title

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • iui docs/superpowers/specs/2026-10-12-mor-2627-replacement-policy-design.md §3(binding 필드 대응)
  • spec/capability-table.md:286(P3)
spec_refs(카드 yaml)
mor2627-127 · cap-284 · cap-286
spec_refs(manifest)
mor2627-127 · cap-284 · cap-286
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D4 제목 자리가 있는데 문서 제목이 빠짐

전달 저하 준수 근처 1.91% [1.75–2.07] 장

무엇

이름
제목 자리가 있는데 문서 제목이 빠짐
링크
대치
단위(셀)
장
기본 m
기본 m 판정, 미달
등급
전달 저하
카드 상태
status fix · tier confirmed

결함 답과 등급

답뜻결함등급
slot_filled있음, 넣음
slot_missing있음, 빠짐결함전달 저하
no_slot자리 없음

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 유저 규칙 10/19(21 문서 0.1)
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
달성

무엇을 잡나

컴포넌트에 전체 제목 자리가 있는데 문서 제목이 들어가지 않고 임시 문구나 템플릿 글이 남거나, 항목이 둘 이상인데 한 항목의 label 이 전체 제목 자리로 올라간 일을 잡는다. 어울리는 자리가 있을 때 안 넣으면 결함이고 자리가 없으면 결함이 아니라는 유저 규칙이다(user-title-1019, 10/19). 대치 링크의 책임이고 문서 제목은 이 장의 YAML 몫의 title 이다(유저 결정 10/23). 항목마다 붙는 라벨은 제목 자리가 아니며, 제목이 두 번 보이는 것은 D5 몫이다.

어떻게

질문

컴포넌트에 제목 노릇을 하는 글 자리가 있는데 문서 제목이 거기 없는가?
문서 제목 = page_yaml 의 title(이 장을 만드는 데 들어간 YAML 몫의 머리말 제목).
제목 자리 = 컴포넌트 전체를 이름 붙이는 글 자리 하나다. 경계 밖 위성 Title(outside_text 의 role Title)이나 경계 안 전체 제목 자리가 그것이다. 항목마다 붙는 라벨(카드 제목, 단계 제목, 열 머리글, 행 이름, 번호 옆 소제목)은 제목 자리가 아니다. 부제 자리와 설명 자리(「부제목을 입력해주세요.」, 「설명을 입력해주세요.」)도 제목 자리가 아니다.
(1) slot_filled: 제목 자리에 문서 제목이나 그 줄임, 요약 제목이 들어 있다. binding 에 field 가 title 인 글이 있으면 여기다. 항목이 하나뿐인 컴포넌트(강조문, 한 문단)에서 그 항목의 label 이 제목 자리를 차지한 것도 여기다.
(2) slot_missing: 제목 자리가 있는데 임시 문구(「제목을 입력해주세요.」, 「제목」)나 템플릿 글이 남아 있거나, 항목이 둘 이상인데 그중 한 항목의 label 이 전체 제목 자리로 올라가 있다.
(3) no_slot: 제목 자리가 없다. 행마다 제목이 라벨인 구조(카드 목록, 단계, 표, 좌우 비교, 번호 목록)에 전체 제목 자리가 따로 없으면 여기다.
문서 제목이 본문 항목 글로만 보이는 것은 자리 판단과 무관하다. 문서 제목이 두 번 보이는 것은 D5 몫이다.
입력 자료
page_yaml binding outside_text inside_unbound_text result_thumb spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 title_slot_missing
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
rule_extra = title_missing_by_side, 집계 = ratio
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
427 단위 · fable+gpt55 127 · fable-N(단독) 300
정답 대조 수 · 양성
200 · 양성 3 (규칙 대조)
정밀도
0.25
재현율
0.33
F1
0.29
반복 일치(3회 최빈 비율)
0.97
규칙 대조 일치
0.90 (200 단위)
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 84.7% · 결함 여부 100.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정
보정 식(참고)
1.91% × 0.25 ÷ 0.33 = 1.43%

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.2: 규칙

결과

1.91% [1.75–2.07]

542/28,446 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 규칙
측정값 [95%]
1.91% [1.75–2.07] · 542/28,446 장
보정값
—
판정
준수 근처
신뢰도 표지
규칙 대조 200 · 정밀도 0.25 · 반복 0.97
25 문서 판정
확정
쉬운 / 어려운 조건
0.8% / 8.8%
찾기 차이 / 확인 차이
+8.3 [5.9–11.1] / +7.8 [5.8–9.9]
목표(제안) · 근거
0.76–0.88% · 쉬운 조건(D-d)
규약 참고(53)
0–1%
도달 · 거리
미달 · +1.03%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
0.87% [0.59–1.27] 26/2,987
답 분포(30c, 운영 조건 셀)
slot_filled: 254(42.3%), slot_missing: 14(2.3%), no_slot: 332(55.3%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-p1 격자 노드 없음 대 격자(Table, Chart) 노드 있음0.80% 196/24,6439.10% 346/3,803표, 차트 컴포넌트의 제목 자리는 격자 머리와 섞여 있다(제안)
D-d 경계 밖 글 없음 대 경계 밖 글 있음0.76% 186/24,4218.84% 356/4,025제목 자리 판단이 경계 하나 안에서 끝난다(05 문서 4.1, frame-plan 5.2절 outsideText)

채택 연결

자료 없음

사례

D4 사례 결과 그림
결과

규칙 판정 결함 · 순위 8 · 유형 Steps · 단위 d9d9f928c9dcde588a1f41a0a57015b9#0#r8

D4 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 List · 단위 ed6abb9b015809cf33d6da7885ec12f6#0

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 유저 규칙 10/19(21-replace-cards.md §0.1)
  • iui packages/comp-frame-client/src/titleCandidate.ts:250-285
  • 30-human-truth-fable.md(라벨러 규칙: 단일 entity 라벨이 제목 자리를 차지하면 slot_filled, 행마다 제목이 라벨이면 no_slot)
spec_refs(카드 yaml)
user-title-1019 · user-title-rule
spec_refs(manifest)
user-title-1019 · user-title-rule
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D5 문서 제목이 중복

마감 미흡 기본 밖 2.65% [2.47–2.85] 장

무엇

이름
문서 제목이 중복
링크
대치
단위(셀)
장
기본 m
기본 m 판정, 미달
등급
마감 미흡
카드 상태
status rule · tier confirmed

결함 답과 등급

개수 답(문서 제목이 보이는 횟수), 결함 = n>= 2 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
①, ② 보조. 유저 규칙 10/19 「중복은 항상 결함」
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
미달

무엇을 잡나

문서 제목 글이 컴포넌트에 두 번 이상 보이는 일을 잡는다. 문서 제목 중복은 항상 결함이라는 유저 규칙이고(user-title-rule, 10/19) 대치가 막을 수 있다(기본품질 13 1.1). 대치 링크의 책임이고 문서 제목은 이 장의 YAML 몫의 title 이며(유저 결정 10/23), 노드 글 전체가 제목과 같은 노드만 세고 본문 문장 속에 든 제목 낱말은 중복이 아니다(D5 v2). 제목 자리에 제목이 빠진 것은 D4 몫이다.

어떻게

질문

문서 제목 글이 컴포넌트에 두 번 이상 보이는가?
입력 자료
page_yaml result_thumb node_text_map spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 title_duplicate_count
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
200 · 양성 7 (규칙 대조)
정밀도
0.00
재현율
0.00
F1
0.00
반복 일치(3회 최빈 비율)
0.91
규칙 대조 일치
0.64 (200 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

2.65% [2.47–2.85]

755/28,457 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
마감 미흡
목표 수준
기본 밖
기준값과 출처
기본 밖 기본 판정 밖(30 문서 3.2)
측정값 [95%]
2.65% [2.47–2.85] · 755/28,457 장
보정값
—
판정
기본 밖 기본 판정 밖, 값만 보인다(30 문서 3.2)
신뢰도 표지
규칙 대조 200 · 정밀도 0.00 · 반복 0.91
25 문서 판정
확정
쉬운 / 어려운 조건
1.5% / 9.4%
찾기 차이 / 확인 차이
+5.8 [2.9–9.5] / +9.7 [6.0–14.1]
목표(제안) · 근거
1.54–1.71% · 쉬운 조건(D-d)
규약 참고(53)
0–1%
도달 · 거리
미달 · +0.94%p
정답 조건 값(표본 250 export)
조건 a None [None] 0/0 · 조건 a1 0.00% [0.00–6.31] 0/57
표본 250 운영 조건
5.22% [4.48–6.08] 156/2,987
답 분포(30c, 운영 조건 셀)
0: 501(83.5%), 1: 90(15.0%), 2: 5(0.8%), 3: 3(0.5%), 4: 1(0.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
D-t 제목 위성 없음(titleDropped) 대 제목 위성 있음0.28% 59/21,1359.51% 696/7,322제목 위성이 있어야 「제목 자리와 다른 자리에 같은 제목」이 생긴다
D-d 경계 밖 글 없음 대 경계 밖 글 있음1.54% 377/24,4329.39% 378/4,025경계 밖 원본 제목과 대치한 제목이 함께 남는다(05 문서 4.1, 제안 해석)

채택 연결

자료 없음

사례

D5 사례 결과 그림
결과

규칙 판정 결함 · 순위 10 · 유형 List · 단위 c6ca750bafcea0cfc7fe75f60b1b7af4#0#r10

D5 사례 결과 그림
결과

규칙 판정 결함 · 순위 2 · 유형 LongFormTextLayout · 단위 0d2b3861b7c738b0f63036d0ed34040e#0#r2

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 유저 규칙 10/19(중복은 항상 결함, 21-replace-cards.md §0.1)
spec_refs(카드 yaml)
user-title-1019
spec_refs(manifest)
user-title-1019
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D5.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D6 목록에 있는 글을 대치가 덮지 않음

준수 0.00% [0.00–0.01] 장

무엇

이름
목록에 있는 글을 대치가 덮지 않음
링크
대치
단위(셀)
장
기본 m
기본 m 판정, 도달
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier confirmed

결함 답과 등급

개수 답(남은 노드 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① 보존 허용 목록 밖 글은 덮는다(mor-2627 §3.1)
주 근거
① 규약 위반
53 목표(제안)
0%
53 달성
미달(1 단위)

무엇을 잡나

대치가 받은 목록(사용자 글 자리, 임시 문구 자리, 경계 안 잔여, 경계 밖 글 등)에 있는 글 노드를 대치가 덮지 않아 원본 템플릿 글이 그대로 남는 일을 잡는다. 사용자 글을 받지 못한 글 노드는 보존 예외만 원문으로 두고 나머지는 임시 문구로 채우는 것이 대치 규칙이다(mor2627-127, mor2627-138). 대치 코드만의 귀책으로 좁힌 카드이고(평가틀 37 6절 제안 3) DO 전체의 노드를 규칙으로 세며, Marker, 구조 토큰, Decoration, Annotation 같은 보존 대상은 세지 않는다(mor2627-132). 어느 목록에도 없는 노드는 색인 몫(P2)이다.

어떻게

질문

대치가 받은 목록에 있는 글 노드 가운데, 대치가 덮지 않아 원본 템플릿의 글이 그대로 남은 노드 수를 센다.
목록 = binding 의 노드(사용자 글 자리), blank(임시 문구 자리), inside_unbound_text(경계 안 잔여), outside_text(경계 밖 글), 그리고 frame_iis 의 유닛 필드, 위성(title, subtitle, desc), 표 칸, 관계 노드. 규약은 이 목록의 노드를 하나도 빠짐없이 사용자 글이나 임시 문구로 바꾼다. preserve 는 원문을 두는 목록이라 세지 않는다.
자료 읽는 법: 현재 글은 node_text_map(대치 뒤 노드별 글)과 그림이다. frame_tree 의 text 와 outside_nodes 의 template_text 는 대치 전 템플릿 원문이다. 「남았다」 = 목록에 있는 노드인데 node_text_map 에 그 노드가 없고, 그림에 원문이 그대로 보이는 것이다.
세지 않는 것: 어느 목록에도 없는 노드(대치가 받지 못한 것이라 색인 몫), Marker 와 구조 토큰(VS, TAM/SAM/SOM, A/B/C 같은 숫자 아닌 한 글자), Decoration, Separator, Annotation(각주, 출처, 면책), preserve 에 있는 노드, 원문이 placeholder_table 의 임시 문구인 노드, 질의 필드 접두(「label:」), 차트와 표 요소 안의 수치(글 노드가 아니다). 템플릿의 안내문(「이곳에 ... 입력해 보세요」)은 목록에 있으면 템플릿 글로 센다.
답은 남은 노드 수다. 하나도 없으면 0.
입력 자료
result_thumb node_text_map frame_tree outside_nodes binding blank inside_unbound_text outside_text preserve frame_iis placeholder_table spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 template_text_left_count
비교 기준
원본 트리 · 색인 (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
430 단위 · fable+gpt55 149 · fable-N(단독) 281
정답 대조 수 · 양성
199 · 양성 0 (규칙 대조)
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
1.00
규칙 대조 일치
1.00 (199 단위)
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 99.3% · 결함 여부 100.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)

결과

0.00% [0.00–0.01]

0/28,371 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
바닥 규칙 대조 199 · 양성 0 · 대조 반복 일치 1.00 · 측정 0
측정값 [95%]
0.00% [0.00–0.01] · 0/28,371 장
보정값
—
판정
준수 목표 0 · 측정 0/28,371, 구간 상한 0.01%
53 문서 근거
① 규약 위반 · 53 목표(제안) 0%
신뢰도 표지
규칙 대조 199 · 양성 0 · 반복 1.00
25 문서 판정
확정
쉬운 / 어려운 조건
0.0% / 0.0%
찾기 차이 / 확인 차이
+0.0 [0.0–0.0] / +0.0 [0.0–0.0]
목표(제안) · 근거
0% · 규약(정의상 0)
규약 참고(53)
0%
도달 · 거리
도달 · +0.00%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
0.03% [0.01–0.19] 1/2,987
답 분포(30c, 운영 조건 셀)
0: 600(100.0%)

조건별 관측(2,000 운영)

자료 없음

채택 연결

자료 없음

사례

사례 없음 (결함 단위 0)

출처

  • design/iis-consistency-gate.md:33
  • iui docs/superpowers/specs/2026-10-12-mor-2627-replacement-policy-design.md §3.1(보존 허용 = Marker, Decoration, Separator, Annotation, 구조 토큰)
  • design/decoration-model.md:160,309
  • 28-fix-round-1.md D3(frame_tree.text 는 대치 전 템플릿 원문)
  • iui packages/comp-frame-shared/src/nodeTextPolicy.ts:256-299(binding, blank, preserve, 경계 안 잔여, 경계 밖, 문서 제목 순서로 반드시 글을 정한다)
  • 37-residue-attribution.md §6 제안 3(대치 코드만의 귀책)
spec_refs(카드 yaml)
gate-33 · mor2627-132 · mor2627-138 · mor2627-150 · deco-309
spec_refs(manifest)
gate-33 · mor2627-132 · mor2627-138 · mor2627-150 · deco-309
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D6.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
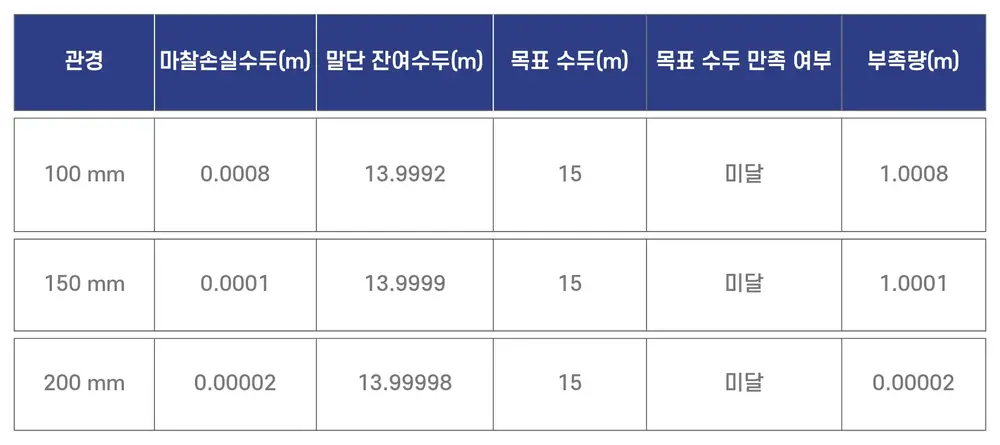
대치 · 장 단위 · 기본 m

D7 표와 차트 칸 값이 다름

내용 오류 보류 3.77% [3.33–4.27] 장

무엇

이름
표와 차트 칸 값이 다름
링크
대치
단위(셀)
장
기본 m
기본 m 판정, 미달
등급
내용 오류
카드 상태
status fix · tier confirmed

결함 답과 등급

개수 답(다른 칸 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
① schema-v0.5:289–290
주 근거
① 규약 위반
53 목표(제안)
0–1%
53 달성
미달

무엇을 잡나

결과의 표, 차트 칸 값이 질의 dataset 의 같은 자리 값과 다른 일(값이 다름, 다른 칸 값이 들어감, 값이 있는데 칸이 비거나 임시 문구)을 잡는다. dataset 값은 계산이 아니라 표시와 대치 대상이라 그대로 같은 칸에 들어가야 한다(schema-0.5-289). 대치 링크의 책임이고 비교 대상은 이 장의 YAML 몫의 dataset 이라 표 나눠 담기 장은 자기 행 구간만 맞대며(유저 결정 10/23), 열 수를 넘는 질의 값과 템플릿에 첫 열 머리글 칸이 없는 것은 결함이 아니다(기본품질 14 Q8, Q9). 생성 dataset 의 모양은 G5, 색인 칸 지도는 P4 몫이다.

어떻게

질문

결과의 표, 차트 칸과 질의 dataset 의 칸을 같은 자리끼리 맞대고 값이 다른 칸 수를 센다.
- 결과 칸 = frame_iis 의 칸 지도가 가리키는 노드의 node_text_map 글(행, 열 순서 그대로). 표 자리(grid) 노드 하나면 그 노드 글의 파이프 표(| a | b |)를 행, 열로 편다.
- 질의 칸 = page_yaml 의 dataset 의 columns(머리글 행) + rows. page_yaml 은 이 장을 만드는 데 들어간 YAML 몫이라 표 나눠 담기의 다른 쪽 행은 들어 있지 않다(이 장의 행 구간만). 다른 수준의 dataset 과 겹쳐 세지 않는다.
- 같음: 공백, 줄바꿈, 천 단위 쉼표, 대소문자 차이. 머리글 「라벨(단위)」. 값 뒤에 단위만 붙은 것(12 → 12억원, 25.0 → 25.0%). 소수점 뒤 0 을 뗀 것(25.0 → 25, 25%). 질의가 null 인 칸이 빈 글이거나 임시 문구인 것.
- 다름: 값 자체가 다르다, 다른 칸의 값이 들어갔다, 질의 값이 있는데 칸이 비었거나 임시 문구다, 값 앞뒤에 단위가 아닌 글이 붙었다.
- 세지 않는 것: 질의 행의 값이 columns 수보다 많을 때 넘치는 값(열 수까지만 맞댄다. 자리 부족은 다른 카드 몫), 결과 표에 첫 열 머리글 칸이 아예 없어(칸 지도의 첫 머리글 자리가 없음) 질의 첫 머리글이 들어갈 자리가 없는 것(템플릿 구조).
frame_iis 의 dataset 이 없음이면(결과가 표, 차트가 아니라 목록 등으로 대체됨) 맞댈 칸이 없으므로 0 으로 답한다.
입력 자료
page_yaml frame_iis node_text_map binding spec_excerpt
측정기
규칙
정답 종류
rule · 규칙 cell_value_match_unit_normalized
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v5 (카드 yaml 지금 v6)

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
190 · 양성 67 (규칙 대조)
정밀도
0.94
재현율
0.46
F1
0.62
반복 일치(3회 최빈 비율)
0.89
규칙 대조 일치
0.67 (190 단위)
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
hold3 사람 라벨 30(mryu, 10/26, 검토 뒤 최종본) · 표본 결함 1/30 = 3.3% [0.6–16.7]
정밀도 1.00 [0.14–1.00] (v6 결함 1/1 단위) · 재현율 정하지 못함 [0.08–0.97] · 일치 100.0% (표본 그대로 30/30) · 층 가중
보정 3.8% [1.7–22.2] → 보류 유지(표본 n 필요) · 종전(모델 라벨) 보정 불명 · 검토 전 답 기준 22.5% [8.2–45.7]
표본은 수정 전 v5 규칙으로 뽑혀 v6 결함 243 가운데 1 단위만 들었다(사람도 결함). v5 만 결함이던 19 단위는 사람이 모두 0 이라 규칙 수정을 지지한다(사람과 일치: v6 규칙 30/30, v5 규칙 11/30, LLM 27/30). v6 결함의 정밀도는 1 단위라 정해지지 않는다. 더 필요한 라벨: v6 규칙 결함(LLM 양수 238)에서 약 70, 규칙 0 쪽에서 약 250(특히 v5 결함 · LLM 양수 · v6 0 인 1,722 층, 표본 0). 출처 48 문서
관문(25 문서 3절)
규칙 · 확정

한계

  • 관문(25 문서 3절): 보드 값이 규칙값(13 2절, manifest tier_rules)
  • 30 문서 4.1: 정밀도 0.94 재현율 0.46 이나 규칙과 LLM 이 갈리고(일치 0.67) 근거 다수가 「머리글 행 없음」이었다. 그 꼴은 규칙 수정으로 풀렸다
  • 30 문서 4.4: 머리글 행 자리가 없는 ListingTable 에서 제품은 열 제목을 일부러 버리고 데이터를 0행부터 넣는다(iui `align.rs`, MOR-2683). 규칙은 질의 머리글을 결과 0행과 맞대 모든 칸이 한 줄씩 밀려 다르다고 세고 있었다. 규칙을 카드 질문대로 고쳤다(카드 D7 v6, 32 문서 4절 A).

결과

3.77% [3.33–4.27]

243/6,440 장 · agg-2k-4 D7(generation 20261025T044725Z-606979e5, 30 문서 4.4 규칙 수정 뒤)

규칙 수정 전: 31.0% [29.9–32.1] 1,996/6,440

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 사람 라벨 30 보정, 판정 선 3.5%(제안)
측정값 [95%]
3.77% [3.33–4.27] · 243/6,440 장
보정값
3.8% [1.7–22.2] 사람
판정
보류 유지(표본 n 필요). 사람 라벨 30 · 보정 3.8% [1.7–22.2]
신뢰도 표지
사람 라벨 30 · 정밀도 1.00 · 규칙 대조 190 · 정밀도 0.94 · 반복 0.89 · 수정 전 판
25 문서 판정
확정
쉬운 / 어려운 조건 (규칙 수정 전 값)
40.2% / 1.6%
찾기 차이 / 확인 차이 (규칙 수정 전 값)
-36.7 [-41.9–-30.8] / -40.5 [-45.2–-35.9]
목표(제안) · 근거
0–1% · 규약
규약 참고(53)
0–1%
도달 · 거리 (규칙 수정 전 값)
미달 · +29.99%p
거리(규칙 수정 뒤 값으로 계산)
+2.77%p
정답 조건 값(표본 250 export)
조건 a 2.50% [0.69–8.66] 2/80 · 조건 a1 2.68% [1.23–5.72] 6/224
표본 250 운영 조건
6.57% [3.5–12.0] 9/137
답 분포(30c, 운영 조건 셀)
0: 483(80.5%), 1: 13(2.2%), 2: 19(3.2%), 3: 15(2.5%), 4: 13(2.2%), 5: 3(0.5%), 6: 7(1.2%), 8: 8(1.3%), 9: 13(2.2%), 10: 7(1.2%), 11: 3(0.5%), 12: 12(2.0%), 13: 1(0.2%), 14: 1(0.2%), 15: 1(0.2%), 16: 1(0.2%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-p1 격자(Table, Chart) 노드 있음 대 격자 노드 없음0.95% 35/3,6767.53% 208/2,764표, 차트 질의를 격자 없는 컴포넌트에 글로 담은 장을 규칙이 칸 대조로 센다(제안, 25 문서 6절 1 과 같은 자리)
D-d 경계 밖 글 있음 대 경계 밖 글 없음1.43% 22/1,5394.51% 221/4,90123 문서 2.5 의 D7 역방향과 같다

채택 연결

자료 없음

사례

D7 사례 결과 그림
결과

규칙 판정 결함 · 순위 5 · 유형 ListingTable · 단위 a17baf39015c8a6234b3eab2213ca74d#0#r5

D7 사례 결과 그림
결과

규칙 판정 결함 · 순위 10 · 유형 ListingTable · 단위 02114f9f67f82982ca96ca041d71c35b#1#r10

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • spec/schema-v0.5.md:289-290
  • MOR-2513 머리글 규칙(rust/comp-pass/crates/comp-frame-core/src/query_frame.rs:389-399)
spec_refs(카드 yaml)
schema-0.5-289 · qframe-389
spec_refs(manifest)
schema-0.5-289 · qframe-389
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D7.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D8 글이 상자를 벗어나거나 다른 요소와 겹침

전달 저하 준수 근처 5.25% [4.99–5.51] 장

무엇

이름
글이 상자를 벗어나거나 다른 요소와 겹침
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
overflow벗어남결함전달 저하
overlap겹침결함전달 저하
both둘 다결함전달 저하
none없음

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
③ 70% 축소 뒤에도 넘치는 몫은 공급 용량 하한. 조항 없음(poc-guide:395)
주 근거
③ 구조 하한
53 목표(제안)
2–3%
53 달성
미달

무엇을 잡나

대치된 컴포넌트에서 글이 자기 상자 밖으로 나가거나 다른 글, 그림과 겹치는 일을 잡는다. 넘침은 PoC 에서 나쁜 결과의 1순위 원인이었고(poc-395), 「텍스트 표현」 묶음의 T2 로 대치의 기본 품질에 든다(유저 결정 10/23). 대치 링크의 책임이고 결과 그림으로 판단한다. 줄이 갈린 것은 T1, 도형 안에서 자리가 치우친 것은 T4, 원본 글이 애초에 용량을 넘은 원인 쪽은 C1 몫이다(기본품질 19 2.2, 4절). 지금 동작은 원본 그림과 대조하지 않고 결과 그림만 보는 것이다(유저 결정 10/24).

어떻게

질문

컴포넌트에서 글이 자기 상자 밖으로 나가거나 다른 글, 그림과 겹친 곳이 있는가?
입력 자료
result_thumb spec_excerpt
측정기
LLM
정답 종류
human
비교 기준
결과 그림만 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
442 단위 · fable+gpt55 142 · fable-N(단독) 300
정답 대조 수 · 양성
442 · 양성 17
정밀도
0.67
재현율
0.71
F1
0.69
반복 일치(3회 최빈 비율)
0.99
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 94.7% · 결함 여부 96.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
5.25% × 0.67 ÷ 0.71 = 4.95%

한계

  • 관문(25 문서 3절): F1 0.69, 양성 17
  • 30 문서 4.2: W 3.5%(2/57, 표본 작음). 정밀도 0.67

결과

5.25% [4.99–5.51]

1,492/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
W W 3.5%(2/57, 표본 작음). 정밀도 0.67
측정값 [95%]
5.25% [4.99–5.51] · 1,492/28,445 장
보정값
—
판정
준수 근처 (W 표본 확대 필요)
신뢰도 표지
라벨 442 · 정밀도 0.67 · 반복 0.99
25 문서 판정
측정 중
쉬운 / 어려운 조건
4.4% / 10.5%
찾기 차이 / 확인 차이
+5.6 [3.4–7.9] / +6.6 [4.6–8.8]
목표(제안) · 근거
4.38–4.64% · 쉬운 조건(D-d)
규약 참고(53)
2–3%
도달 · 거리
(미달) · +0.61%p
정답 조건 값(표본 250 export)
조건 a None [None] 0/0 · 조건 a1 3.51% [1.0–11.9] 2/57
표본 250 운영 조건
5.56% [4.79–6.44] 166/2,985
답 분포(30c, 운영 조건 셀)
overflow: 2,269(2.2%), overlap: 3,273(3.2%), both: 397(0.4%), none: 97,546(94.3%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
D-d 경계 밖 글 없음 대 경계 밖 글 있음4.38% 1,070/24,42410.5% 422/4,021배치가 경계 하나 안에서 끝난다(05 문서 4.1)
M-table 장 범위 표 나눠 담기 대 장 범위 표 나눠 담기 밖1.15% 41/3,5695.81% 1,434/24,687표 나눠 담기는 행 수를 칸에 맞춰 나눠 넘치지 않는다(제안)

채택 연결

채택 오즈비 (95%)
0.77 (0.59–1.00)
채택 장 결함 % / 비채택 장 결함 %
4.8 / 5.9
이 카드 하나만 고칠 때 KR1
+0.4 (0.0–0.7)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

D8 사례 결과 그림
결과

모델 답 벗어남 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 제목과 하단 글머리표 문장이 오른쪽 화면 경계를 넘어 잘려 있습니다.

D8 사례 결과 그림
결과

모델 답 겹침 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 PieChart · 단위 acdc01f2e97cc5f213d64060c29c7bd8#1

모델 근거(3회 중 첫 답): 원형 차트 위에 흰색 라벨 글자가 겹쳐 배치되어 있습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • plan/poc-guide.md:395(넘침은 1위 결함, 규약 조항 없음)
spec_refs(카드 yaml)
poc-395
spec_refs(manifest)
poc-395
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D8.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

D9 단어 중간 줄바꿈

미준수 32.7% [30.9–34.5] 장

무엇

이름
단어 중간 줄바꿈
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status light · tier confirmed

결함 답과 등급

개수 답(분절 수), 결함 = n> 0 (집계 ratio)

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
자료 없음
53 달성
정할 수 없음

무엇을 잡나

글이 단어 중간에서 줄이 바뀐 일(「대/상자」)을 잡는다. 단어 잘림을 결함으로 센다는 결정이 있다(평가틀 40 Q2, 평가틀 21 2절 D9 가독 원칙). 대치 링크의 책임이고 그림 모델이 읽은 줄바꿈 위치를 규칙으로 판정하며, 원본 그림에도 있던 잘림과 대치되지 않은 임시 문구의 줄바꿈은 세지 않는다(기본품질 14 Q10). T1 의 word_split 과 같은 사건이다(기본품질 19 2.1). T1 로 접는 것은 아직 결정 전이라, 지금은 독립 카드로 돈다(유저 결정 10/24).

어떻게

질문

글이 단어 중간에서 줄이 바뀐 곳이 있는가? 대치되지 않은 임시 문구(「"설명"」, 「"제목을 입력해주세요."」 같은 템플릿 안내 글)의 줄바꿈은 세지 않는다.
입력 자료
result_thumb
측정기
규칙
정답 종류
rule · 규칙 wordbreak_excl_origin
비교 기준
결과 그림만 (입력 이름으로 나눔)
범위
top10
집계 규칙
자료 없음
카드 버전
v3

신뢰도

정답 종류
rule
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
자료 없음
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
규칙 · 측정 중

한계

  • 관문(25 문서 3절): 규칙은 믿을 만하나 순위 1 장만 값이 나고 T1 접기 결정 전(13 2절, 24 D9)

결과

32.7% [30.9–34.5]

823/2,518 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
—
목표 수준
0
기준값과 출처
원본 대조 내장 잡음 폭 0.00% [0.00–3.00](그림 판정 재현 124/124, 17 문서 2.6)
측정값 [95%]
32.7% [30.9–34.5] · 823/2,518 장
보정값
—
판정
미준수 목표 0 · 운영 하한 30.9% 대 잡음 폭 상한 3.00% 로 잡음 위로 갈린다
기준값 대조
잡음 폭 출처: 「공통 DO 124 의 판정이 124/124 같다」(17 문서 2.6). 규칙 자체는 결정적이고 입력 그림 판정의 재현을 잡음으로 둔다
53 문서 근거
정하지 못함(1.7 근거별 집계에서 빠짐)
신뢰도 표지
라벨 없음
25 문서 판정
측정 중
쉬운 / 어려운 조건
32.4% / 37.8%
찾기 차이 / 확인 차이
+15.5 [-3.6–32.5] / -3.0 [-15.2–8.3]
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
조건 a None [None] 0/0 · 조건 a1 0.00% [0.0–43.4] 0/5
표본 250 운영 조건
33.1% [26.3–40.7] 53/160
답 분포(30c, 운영 조건 셀)
자료 없음

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
S-d 상위 10 모두 tier 1 대 tier 2–3 섞임이나 10 미만30.4% 677/2,22850.3% 146/290투영으로 다른 종 상자에 글을 옮기면 상자 폭이 글에 맞지 않는다(제안). 쉬운 쪽도 30% 라 대부분 체계 몫
I-g Highlight, Annotation 등 다른 역할 글 있음 대 글 역할 넷 안17.6% 46/26234.4% 777/2,256해석 없음(제안 보류). 배수 1.0 이라 진단 가치가 작다

채택 연결

자료 없음

사례

D9 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 List · 단위 b0088a6574c55960d441172cf134e96a#3

D9 사례 결과 그림
결과

규칙 판정 결함 · 순위 1 · 유형 LongFormTextLayout · 단위 0a26cd3e82637dbb18e6f8f4d48bac8d#0

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 가독 원칙(21-replace-cards.md §2 D9)
  • vs-eval-v2/tools/picture/vis_wordbreak.py
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/D9.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

T1 원본에 없던 어색한 줄바꿈

전달 저하 미준수 38.0% [37.4–38.5] 장

무엇

이름
원본에 없던 어색한 줄바꿈
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
token_split마커, 번호 갈림결함전달 저하
word_split단어 중간 갈림결함전달 저하
short_line한두 글자 줄결함전달 저하
meaning_split뜻 덩어리 갈림결함전달 저하
none없음

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

대치 결과에 원본에 없던 어색한 줄바꿈이 생긴 일, 곧 번호나 마커가 두 줄로 갈림, 단어 중간 줄바꿈, 한두 글자만 다음 줄에 남음, 숫자와 단위처럼 한 덩어리여야 할 말이 갈림을 잡는다. 원본 디자인 품질을 가장 크게 좌우하는 것이 텍스트 표현이라 단순 스타일이 아니라 대치의 기본 품질이다(유저 결정 10/23, 기본품질 19 1절). 대치 링크의 책임이고 결과 그림을 원본 그림과 견주어 판정하며, 대치 문서의 규칙 값은 렌더 전 예측이라 층화와 일치도에만 쓰고 줄 수가 원본과 다른 것 자체는 결함이 아니다(같은 결정). 상자 밖 이탈은 D8, 정렬은 T4 몫이다.

어떻게

질문

origin_do_thumb 는 글을 바꿔 넣기 전 같은 컴포넌트(원본)이고 result_thumb 는 글을 바꿔 넣은 결과다. 두 그림을 견주어, 결과에 원본에 없던 어색한 줄바꿈이 있는가?
세는 것:
- token_split: 마커, 번호, 구조 토큰(「01」, 「02」, 「①」, 「Step 1」, 「A.」)이 두 줄로 갈리거나 세로로 쪼개짐(원 안 「01」이 「0」과 「1」로 두 줄). 대치되지 않고 남은 마커, 번호, 구조 토큰도 센다.
- word_split: 단어 중간에서 줄이 갈림(「대/상자」, 「Manage/ment」).
- short_line: 줄이 넘어가 한두 글자만 다음 줄에 남음(「아동보호전문기관 교육 내/용」의 「용」).
- meaning_split: 숫자와 단위, 이름, 날짜처럼 한 덩어리로 읽혀야 할 말이 갈려 뜻이 끊김(「54,012/원」, 「2026년 9/월」).
여럿이면 위 순서에서 앞의 것을 답한다.
세지 않는 것: 줄 수가 원본과 다른 것 자체, 띄어쓰기 자리나 문장 부호 뒤에서 자연스럽게 바뀐 줄, 원본 그림에도 같은 꼴로 있던 줄바꿈, 대치되지 않은 템플릿 안내 임시 문구(「"설명"」, 「"제목을 입력해주세요."」)의 줄바꿈, 글이 상자나 도형 밖으로 나간 것(D8 몫), 정렬 어긋남(T4 몫).
입력 자료
origin_do_thumb result_thumb
측정기
LLM
정답 종류
human
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.97
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 사람 정답 없음
  • 30 문서 4.2: 원본 대조 내장, 반복 0.97. 단어 중간 갈림 30.9% 가 대부분, 뜻 끊김 2.8%, 마커 2.3%, 한두 글자 2.1%

결과

38.0% [37.4–38.5]

10,803/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
원본 대조 내장 원본 대조 내장, 반복 0.97. 단어 중간 갈림 30.9% 가 대부분, 뜻 끊김 2.8%, 마커 2.3%, 한두 글자 2.1%
측정값 [95%]
38.0% [37.4–38.5] · 10,803/28,445 장
보정값
—
판정
미준수 (가장 큼)
신뢰도 표지
라벨 없음 · 반복 0.97
25 문서 판정
측정 중
쉬운 / 어려운 조건
35.8% / 51.5%
찾기 차이 / 확인 차이
+14.7 [9.4–19.7] / +16.7 [11.4–22.2]
목표(제안) · 근거
35.76–36.36% · 쉬운 조건(D-d)
규약 참고(53)
자료 없음
도달 · 거리
(미달) · +1.62%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
token_split: 1,921(2.3%), word_split: 26,348(30.9%), short_line: 1,800(2.1%), meaning_split: 2,365(2.8%), none: 52,901(62.0%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-e 내용 그림(사진, 아이콘) 있음 대 내용 그림 없음20.9% 754/3,60640.5% 10,049/24,839글만 있는 컴포넌트는 글 노드가 많아 줄바꿈 기회가 많다(제안)
D-d 경계 밖 글 없음 대 경계 밖 글 있음35.8% 8,733/24,42451.5% 2,070/4,02105 문서 4.1. 25 문서 6절 2 의 값과 같다. 쉬운 쪽도 35.8% 라 체계 몫

채택 연결

채택 오즈비 (95%)
0.84 (0.72–0.98)
채택 장 결함 % / 비채택 장 결함 %
37.6 / 39.6
이 카드 하나만 고칠 때 KR1
+1.8 (0.1–3.3)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

T1 사례 원본 그림
원본
T1 사례 결과 그림
결과

모델 답 한두 글자 줄 · 반복 3회 중 최빈 비율 1.00 · 순위 6 · 유형 List · 단위 d3f1163bd4bf3400b26881561f11165d#0#r6

모델 근거(3회 중 첫 답): 첫 번째 카드의 첫 글머리표에서 ‘초성’ 두 글자만 다음 줄에 남습니다.

T1 사례 원본 그림
원본
T1 사례 결과 그림
결과

모델 답 단어 중간 갈림 · 반복 3회 중 최빈 비율 1.00 · 순위 8 · 유형 ListingTable · 단위 30a268b794252c980fe7290bfc57f4f6#1#r8

모델 근거(3회 중 첫 답): ‘2018 기준연도’가 ‘2018 기준연’ / ‘도’로 갈려 단어 중간에서 줄바꿈됩니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 19-text-expression.md §2 T1(유저 결정 10/23, 메모리 feedback-text-expression-visual-judgment)
  • cards/D9.yaml(단어 중간 줄바꿈, T1 의 word_split 하위값)
  • vs-eval-v2/tools/picture/vis_wordbreak.py
  • 유저 사례 10/23(원 안 번호 「01」이 「0 / 1」로 갈림)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/T1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

T3 원본보다 글자가 지나치게 작음

전달 저하 준수 근처 2.95% [2.76–3.15] 장

무엇

이름
원본보다 글자가 지나치게 작음
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
same원본과 비슷
small_minor보조 글이 작음결함전달 저하
small_key핵심 글이 작음결함전달 저하

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

대치 결과의 글이 원본의 같은 자리 글보다, 또 자기 상자나 도형에 비해 지나치게 작아 보이는 일을 잡는다. 텍스트 표현은 원본 디자인 품질을 좌우하는 대치의 기본 품질이다(유저 결정 10/23). 대치 링크의 책임이고 결과 그림을 원본 그림과 견주며, 검색의 축소 허용(0.7 배) 안이라도 그림에서 지나치게 작아 보이면 결함이다(기본품질 14 「10/23 결정」). 글이 짧아 상자가 비어 보이는 것과 전체가 함께 줄어든 것은 결함이 아니고, 형제끼리 크기가 달라진 것은 T6, 상자 밖 이탈은 D8 몫이다.

어떻게

질문

origin_do_thumb 는 글을 바꿔 넣기 전 같은 컴포넌트(원본)이고 result_thumb 는 글을 바꿔 넣은 결과다. 두 그림을 견주어, 결과의 글이 원본에 비해, 또 자기 상자나 도형에 비해 지나치게 작아 보이는 곳이 있는가?
작음으로 세는 것: 같은 자리의 원본 글보다 눈에 띄게 작아짐, 글을 줄여 넣어 자기 상자나 도형 안에서 글이 작게 떠 큰 빈 곳이 남음, 작아서 읽기 힘듦.
small_key: 작아진 글이 제목, 항목 이름, 수치 같은 핵심 글이다. small_minor: 설명 일부, 보조 글이다. same: 원본과 비슷하다.
세지 않는 것: 원본과 같은 크기인데 글이 짧아 상자가 비어 보이는 것(글 양 차이), 컴포넌트 전체가 함께 조금 줄어 원본의 크기 관계와 상자 채움이 비슷하게 남은 것, 형제 항목끼리 크기가 달라진 것(T6 몫), 글이 상자 밖으로 나간 것(D8 몫), 글자색이 옅은 것.
입력 자료
origin_do_thumb result_thumb
측정기
LLM
정답 종류
human
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.97
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.2: 원본 대조 내장, 반복 0.97

결과

2.95% [2.76–3.15]

838/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
원본 대조 내장 원본 대조 내장, 반복 0.97
측정값 [95%]
2.95% [2.76–3.15] · 838/28,445 장
보정값
—
판정
준수 근처
신뢰도 표지
라벨 없음 · 반복 0.97
25 문서 판정
측정 중
쉬운 / 어려운 조건
2.8% / 4.0%
찾기 차이 / 확인 차이
+1.0 [-0.2–2.1] / +1.4 [0.3–2.6]
목표(제안) · 근거
2.77–2.99% · 쉬운 조건(잠정)(D-d)
규약 참고(53)
자료 없음
도달 · 거리
(도달) · -0.04%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
same: 81,550(95.6%), small_minor: 1,213(1.4%), small_key: 2,572(3.0%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-e 내용 그림(사진, 아이콘) 있음 대 내용 그림 없음1.08% 39/3,6063.22% 799/24,839글만 있는 컴포넌트는 담을 글이 많아 줄인다(제안)
D-t 제목 위성 없음(titleDropped) 대 제목 위성 있음2.44% 516/21,1304.40% 322/7,315긴 문서 제목을 작은 제목 위성에 넣으며 줄인다(제안)

채택 연결

자료 없음

사례

T3 사례 결과 그림
결과

모델 답 핵심 글이 작음 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 PieChart · 단위 acdc01f2e97cc5f213d64060c29c7bd8#1

모델 근거(3회 중 첫 답): 파이 차트의 항목명과 수치가 원본 라벨보다 눈에 띄게 작아져 있다.

T3 사례 결과 그림
결과

모델 답 보조 글이 작음 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 Steps · 단위 d221b5409cf9fd045a3e1a97fd3dc8df#7

모델 근거(3회 중 첫 답): 제목 크기는 비슷하지만, 각 상자 안의 설명·목록 글씨가 원본의 보조 글보다 눈에 띄게 작습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 19-text-expression.md §2 T3(유저 결정 10/23, 메모리 feedback-text-expression-visual-judgment)
  • tools/eval/rules/w_format_check.py(D1 의 글자 크기 비, 규칙 보조값 font_ratio_min)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/T3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

T4 원본에서 맞던 정렬이 어긋남

전달 저하 미준수 14.5% [14.1–14.9] 장

무엇

이름
원본에서 맞던 정렬이 어긋남
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
kept정렬 지켜짐
misaligned어긋난 곳 있음결함전달 저하
broken배치가 흐트러짐결함전달 저하

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

원본에서 맞던 글 정렬(가로, 세로, 형제 유닛 사이의 줄)이 대치 결과에서 어긋나 보이는 일, 예로 가운데였던 제목이 한쪽으로 붙거나 원 안 번호가 치우치거나 형제 카드의 제목 줄 높이가 달라지는 일을 잡는다. 텍스트 표현은 대치의 기본 품질이다(유저 결정 10/23). 대치 링크의 책임이고 결과 그림을 원본 그림과 견주며, 글 양 차이로 아래 끝만 다른 것과 원본에도 있던 어긋남은 결함이 아니다. 줄바꿈 자리는 T1, 상자 밖 이탈은 D8, 유닛 간 글 양 균형과 여백은 E6 몫이다(기본품질 19 4절).

어떻게

질문

origin_do_thumb 는 글을 바꿔 넣기 전 같은 컴포넌트(원본)이고 result_thumb 는 글을 바꿔 넣은 결과다. 두 그림을 견주어, 원본에서 맞던 글 정렬이 결과에서 어긋나 보이는가? 가로 정렬(왼쪽, 가운데, 오른쪽), 세로 정렬(위, 가운데, 아래), 형제 유닛 사이의 줄(같은 줄에 놓인 제목, 번호, 글머리가 나란함)을 본다.
misaligned 의 예: 원본에서 가운데였던 제목이 한쪽으로 붙음, 원이나 띠 안 가운데 있던 번호와 글이 도형 안에서 치우치거나 아래로 내려감, 형제 카드의 제목 줄 높이가 서로 달라짐, 글머리 기호와 글이 어긋남, 원본에서 위로 맞춘 항목들이 결과에서 들쭉날쭉함. broken: 여러 곳이 어긋나 글 배치가 흐트러짐.
세지 않는 것: 글 양 차이로 줄 수가 달라 아래 끝만 다른 것(기준 줄이 맞으면 정렬은 지켜졌다), 원본에도 있던 어긋남, 유닛 간 글 양 불균형과 여백, 글이 상자나 도형 밖으로 나간 것 자체(D8 몫), 줄바꿈 자리(T1 몫).
입력 자료
origin_do_thumb result_thumb
측정기
LLM
정답 종류
human
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.95
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.2: 원본 대조 내장

결과

14.5% [14.1–14.9]

4,113/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
원본 대조 내장 원본 대조 내장
측정값 [95%]
14.5% [14.1–14.9] · 4,113/28,445 장
보정값
—
판정
미준수
신뢰도 표지
라벨 없음 · 반복 0.95
25 문서 판정
측정 중
쉬운 / 어려운 조건
13.8% / 18.4%
찾기 차이 / 확인 차이
+3.1 [0.5–5.4] / +6.0 [3.8–8.4]
목표(제안) · 근거
13.81–14.24% · 쉬운 조건(D-d)
규약 참고(53)
자료 없음
도달 · 거리
(미달(구간 겹침)) · +0.22%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
kept: 72,238(84.7%), misaligned: 12,526(14.7%), broken: 571(0.7%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-h2 컴포넌트 카테고리 2.2 순서와 흐름 밖 대 컴포넌트 카테고리 2.2 순서와 흐름13.4% 3,437/25,60823.8% 676/2,837단계, 타임라인 종은 형제 정렬이 원본에서 엄격하다(제안)
D-e 슬롯 수 맞물림 대 유닛 공백, items 초과나 부족13.5% 3,404/25,15621.6% 709/3,289빈 자리, 넘친 항목이 형제 줄을 흐트러뜨린다(05 문서 4.1, 제안 해석)

채택 연결

자료 없음

사례

T4 사례 원본 그림
원본
T4 사례 결과 그림
결과

모델 답 어긋난 곳 있음 · 반복 3회 중 최빈 비율 1.00 · 순위 8 · 유형 ListingTable · 단위 30a268b794252c980fe7290bfc57f4f6#1#r8

모델 근거(3회 중 첫 답): 원본의 흰색 카드 내용은 위쪽에 맞춰져 있지만, 결과의 표 셀 내용은 세로 가운데에 배치되어 있습니다.

T4 사례 결과 그림
결과

모델 답 배치가 흐트러짐 · 반복 3회 중 최빈 비율 1.00 · 순위 2 · 유형 List · 단위 a11987a8e29166fbd23d6b737c4ac094#0#r2

모델 근거(3회 중 첫 답): 두 카드 모두 글머리 항목의 세로 간격이 무너져 글줄이 서로 겹쳐 보입니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 19-text-expression.md §2 T4(유저 결정 10/23, 메모리 feedback-text-expression-visual-judgment)
  • tools/eval/rules/w_format_check.py(D1 의 align_changed 관찰, 규칙 보조값 n_align_attr_changed)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/T4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
대치 · 장 단위 · 기본 m

T6 원본의 글자 크기, 굵기 위계가 무너짐

전달 저하 미준수 13.3% [12.9–13.7] 장

무엇

이름
원본의 글자 크기, 굵기 위계가 무너짐
링크
대치
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status light · tier measuring

결함 답과 등급

답뜻결함등급
kept위계 지켜짐
flattened위계가 흐려짐결함전달 저하
inverted위계가 뒤집힘결함전달 저하

기본 m 근거(53 문서)

자료 없음

무엇을 잡나

원본에서 글자 크기와 굵기로 드러나던 위계(제목, 항목 이름, 본문, 보조 글)가 대치 결과에서 뒤집히거나 흐려지는 일, 예로 항목 이름이 본문보다 작아지거나 같은 급이던 형제 항목끼리 크기가 달라지는 일을 잡는다. 텍스트 표현은 대치의 기본 품질이다(유저 결정 10/23). 대치 링크의 책임이고 결과 그림을 원본 그림과 견주며, 전체가 함께 줄어 크기 관계가 그대로인 것은 결함이 아니다. 항목 순서와 설명의 소속은 E5, 한 글의 지나친 축소는 T3 몫이다(기본품질 19 4절).

어떻게

질문

origin_do_thumb 는 글을 바꿔 넣기 전 같은 컴포넌트(원본)이고 result_thumb 는 글을 바꿔 넣은 결과다. 원본에서 글자 크기와 굵기로 드러나던 위계(제목 > 항목 이름 > 본문 > 보조 글)가 결과에서도 지켜지는가?
inverted: 원본에서 더 크거나 굵던 글이 결과에서 더 작거나 가늘어져 순서가 뒤집힘(항목 이름이 본문보다 작아짐). flattened: 원본에서 구분되던 급이 결과에서 같은 크기, 굵기가 되어 구분이 흐려짐, 또는 원본에서 같은 급이던 형제 항목끼리 크기가 달라져 급이 달라 보임. kept: 위계가 지켜짐.
세지 않는 것: 항목 순서와 설명의 소속(E5 몫), 크기 관계는 그대로이고 전체가 함께 줄어든 것, 원본에도 크기 구분이 없던 것, 대치되지 않은 임시 문구.
입력 자료
origin_do_thumb result_thumb
측정기
LLM
정답 종류
human
비교 기준
원본 대조 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v1

신뢰도

정답 종류
human
모델 라벨(사람 대신)
자료 없음
정답 대조 수 · 양성
자료 없음
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.93
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
자료 없음
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음
  • 30 문서 4.2: 원본 대조 내장

결과

13.3% [12.9–13.7]

3,770/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
원본 대조 내장 원본 대조 내장
측정값 [95%]
13.3% [12.9–13.7] · 3,770/28,445 장
보정값
—
판정
미준수
신뢰도 표지
라벨 없음 · 반복 0.93
25 문서 판정
측정 중
쉬운 / 어려운 조건
11.7% / 22.4%
찾기 차이 / 확인 차이
+10.7 [7.3–15.2] / +10.7 [8.0–13.5]
목표(제안) · 근거
11.74–12.15% · 쉬운 조건(D-d)
규약 참고(53)
자료 없음
도달 · 거리
(미달) · +1.10%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
export/eval(generation 20261021T233620Z-1ef10a50) cards/ 에 파일 없음(그 export 의 manifest 카드 46장 밖)
답 분포(30c, 운영 조건 셀)
kept: 71,479(83.8%), flattened: 11,643(13.6%), inverted: 2,213(2.6%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
M-table 장 범위 표 나눠 담기 밖 대 장 범위 표 나눠 담기11.9% 2,942/24,68722.4% 800/3,569머리글과 칸 글자 크기 관계를 쪽마다 지키지 못한다(제안)
D-d 경계 밖 글 없음 대 경계 밖 글 있음11.7% 2,868/24,42422.4% 902/4,021경계 밖 원본 글과 대치 글의 크기가 섞인다(제안)

채택 연결

자료 없음

사례

T6 사례 결과 그림
결과

모델 답 위계가 흐려짐 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 원본의 두 항목 이름은 굵게 강조되지만 결과에서는 첫 항목 이름만 굵고 둘째 항목 이름은 본문과 비슷한 굵기로 보여 형제 항목의 위계가 달라졌습니다.

T6 사례 원본 그림
원본
T6 사례 결과 그림
결과

모델 답 위계가 뒤집힘 · 반복 3회 중 최빈 비율 1.00 · 순위 7 · 유형 Steps · 단위 47f698705fa959f8f14360e8568ffccb#0#r7

모델 근거(3회 중 첫 답): 원본의 단계 제목은 본문보다 크고 굵게 보이지만, 결과에서는 본문 글자가 단계 제목보다 더 크게 보여 위계가 뒤집혔습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 19-text-expression.md §2 T6(유저 결정 10/23, 메모리 feedback-text-expression-visual-judgment)
  • tools/eval/rules/w_format_check.py(D1 의 sibling_mismatch, 규칙 보조값 n_hier_inverted)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/T6.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
종합 · 장 단위 · 기본 m

E1 뜻이 보존되지 않음

내용 오류 준수 1.25% [1.13–1.38] 장

무엇

이름
뜻이 보존되지 않음
링크
종합
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
내용 오류
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
intact같은 주장
different다른 주장결함내용 오류

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④ 다른 카드 몫을 뺀 「다른 주장」만 남은 사람 판단 몫
주 근거
④ 사람 한계
53 목표(제안)
2–3%
53 달성
달성

무엇을 잡나

결과의 글을 모두 받아들이고 읽었을 때, 이 컴포넌트가 맡은 몫이 이 장의 YAML 몫과 다른 주장이 되는 일(부정이나 조건이 빠져 반대 뜻, 이름과 값의 짝이 바뀜, 없던 순서나 인과가 배열로 생김)을 잡는다. 링크 카드가 못 잡는 VS 결과의 핵심이라 기본 품질에 든다(기본품질 13 1.1). 생성부터 대치까지를 거친 종합 결과이고, 비교 대상은 유저 원문이 아니라 이 장의 YAML 몫이며(유저 결정 10/23) 범위는 경계 안이다(평가틀 47 결정 2). 임시 문구(E3), 안 보임(E4, D8), 빠짐(D2, G3), 소속과 순서(E5)는 근거로 쓰지 않고, 「값 없음」 표기는 뜻을 바꾸지 않아 결함이 아니다(평가틀 47 결정 8).

어떻게

질문

이 컴포넌트에 보이는 글을 모두 page_yaml(이 장을 만드는 데 들어간 YAML 몫)에서 온 글로 받아들이고 읽을 때, 이 컴포넌트가 맡은 몫이 page_yaml 과 다른 주장이 되는가?
맡은 몫: binding 의 text 가 이 컴포넌트에 넣은 글이다. 비교 기준은 유저 원문이 아니라 page_yaml 이다. page_yaml 은 이 장(이 컴포넌트)을 만드는 데 들어간 YAML 몫이다. 유저 원문 전체나 L2 의 형제 컴포넌트, 나눠 담기(리스트, 표)의 다른 장으로 간 항목은 들어 있지 않다. 그것이 여기 없는 것은 누락이 아니다. binding 의 글에 대응하는 page_yaml 부분만 비교한다. binding 의 글이 없는 영역(차트와 그 수치, 다른 카드)은 경계 밖이라 이 컴포넌트가 아니다.
intact: 맡은 몫의 주장이 page_yaml 과 같다. 빠진 항목이나 임시 문구가 있어도 남은 글이 page_yaml 과 같은 주장이면 intact 다.
different: 글은 다 있는데 page_yaml 과 다른 주장으로 읽힌다. 부정이나 조건이 빠져 반대 뜻이 됨, 이름과 값(수치, 기간, 담당)의 짝이 바뀜, page_yaml 에 없는 시간 순서나 인과가 표지나 배열로 생겨 다르게 읽힘, 줄여 쓰며 주장이 바뀜.
이 질문에서 결함 근거로 쓰지 않는 것(다른 카드가 잰다): 임시 문구나 템플릿 글이 보임(E3), 글이 가려지거나 잘려 안 보임(E4, D8), 항목이나 글이 빠짐(D2, G3), 설명이 다른 항목에 붙거나 묶음이 갈라지거나 순서가 바뀜(E5), page_yaml 에 없는 수와 단위(G9, D7), 표기와 언어, 대소문자 같은 렌더 서식.
예시(결정 8): 표를 목록으로 펴며 page_yaml 의 빈 칸이 「값 없음」으로 적힌 것은 intact 다. 유저 경험은 해치지만 page_yaml 과 다른 주장을 만들지는 않는다. 예: 「A 제품은 방수 기능이 없다」가 「A 제품: 방수 기능」으로 부정이 빠졌다면 different, 「담당: 김OO, 기간: 3월」이 「담당: 3월」처럼 짝이 바뀌었다면 different 다.
그 밖에 바뀜이 아닌 것: 조사와 어미, 문장 일부를 줄여 쓴 것, 출처, 날짜, 기관명, 메모 같은 부가 정보 생략, 오타 교정, 위성 자리(부제, 설명) 임시 문구, page_yaml 이 도구 지시문을 옮긴 안내문 한 줄이나 제목 한 줄뿐이라 그것만 담긴 것.
입력 자료
page_yaml binding result_thumb
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
human
모델 라벨(사람 대신)
423 단위 · fable+gpt55 123 · fable-N(단독) 300
정답 대조 수 · 양성
422 · 양성 0
정밀도
자료 없음
재현율
자료 없음
F1
자료 없음
반복 일치(3회 최빈 비율)
0.99
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 82.0% · 결함 여부 99.3%
평가기 의심
18% (30 문서 4절 근거 분류)
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중

한계

  • 관문(25 문서 3절): 정답 없음, 양성 0
  • 30 문서 4.1: 라벨 422 에서 양성 0. 근거의 18% 가 평가기 의심(같은 낱말을 다르다고 함)

결과

1.25% [1.13–1.38]

355/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 라벨 422 에서 양성 0. 근거의 18% 가 평가기 의심(같은 낱말을 다르다고 함)
측정값 [95%]
1.25% [1.13–1.38] · 355/28,445 장
보정값
바닥
판정
준수
신뢰도 표지
라벨 422 · 양성 0 · 반복 0.99
25 문서 판정
측정 중
쉬운 / 어려운 조건
1.1% / 3.0%
찾기 차이 / 확인 차이
+0.3 [-0.4–1.2] / +3.4 [1.0–6.7]
목표(제안) · 근거
1.08–1.21% · 쉬운 조건(잠정)(S-d)
규약 참고(53)
2–3%
도달 · 거리
(미달(구간 겹침)) · +0.04%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
2.95% [2.40–3.62] 88/2,985
답 분포(30c, 운영 조건 셀)
intact: 84,598(98.3%), different: 1,429(1.7%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-h2 컴포넌트 카테고리 2.2 순서와 흐름 밖 대 컴포넌트 카테고리 2.2 순서와 흐름1.09% 279/25,6082.68% 76/2,837흐름 표현이 병렬 내용의 뜻을 바꾼다(제안, 15 문서 E2 「흐름 템플릿 오선택」)
I-e 내용 그림(사진, 아이콘) 있음 대 내용 그림 없음0.47% 17/3,6061.36% 338/24,839해석 없음(제안 보류). 확인 구간이 0 에 붙는다

채택 연결

자료 없음

사례

E1 사례 결과 그림
결과

모델 답 다른 주장 · 반복 3회 중 최빈 비율 1.00 · 순위 10 · 유형 ListingTable · 단위 f200789da67dfc4eff5cc42d365d6cc5#0#r10

모델 근거(3회 중 첫 답): 표시된 항목에서 조건·반응시간·전환율 값이 YAML과 다른 열에 대응해 읽힙니다.

E1 사례 결과 그림
결과

모델 답 다른 주장 · 반복 3회 중 최빈 비율 1.00 · 순위 3 · 유형 List · 단위 98e09b2f76bb51c34ab8af358fb48392#0#r3

모델 근거(3회 중 첫 답): page_yaml은 권위를 ‘실추시킴’이라고 했지만, 컴포넌트에는 ‘실추시킴’이 아니라 ‘실추시킴’과 다른 ‘실추시킴’으로 바뀌지 않았고, 실제 문구는 ‘권위를 실추시킴’과 같은 의미다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E1(옛 judge agent_2 누락 부분)
  • 22-overall-cards.md §0 전제 1
  • 17-generation-cards.md §7.2(줄여 쓰기 허용)
  • eval/human/PACKET_INSTRUCTIONS.md(라벨러 전제 1, 나뉜 것은 결함 아님)
  • 46-e1e2-split-and-targets.md §2.4(새 E1 질문 초안), 47-decisions-1020.md 결정 2, 8
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E1.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
종합 · 장 단위 · 기본 m

E2 표현이 내용 구조와 어긋남

내용 오류 보류 9.57% [9.23–9.92] 장

무엇

이름
표현이 내용 구조와 어긋남
링크
종합
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
내용 오류
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
fit어울림
plain무난(일반 목록으로 담김)
mismatch어긋남결함내용 오류

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④ 시각 문법이 구조를 다른 종류로 읽히게 함
주 근거
④ 사람 한계
53 목표(제안)
3–5%
53 달성
미달

무엇을 잡나

이 컴포넌트의 시각 표현이 이 장의 YAML 몫의 내용 구조를 반대로나 다른 종류로 읽히게 하는 일(순서 없는 나열에 단계 화살표, 부분과 전체가 독립 항목처럼 보임, 계층이나 시간 방향이 반대, 표를 목록으로 바꾸며 누구의 값인지 안 읽힘)을 잡는다. 표현이 내용 구조를 거스르지 않는 것은 「맞는 컴포넌트」의 정의다(기본품질 13 1.1). 종합 결과이고 비교 대상은 이 장의 YAML 몫(유저 결정 10/23), 범위는 경계 안이다(평가틀 47 결정 2). 번호만 붙은 나열과 관계가 읽히는 목록 대체는 결함이 아니고(평가틀 47 결정 9, 10), 유형 선택 자체는 G1 몫이다.

어떻게

질문

이 컴포넌트의 시각 표현이 page_yaml(이 장을 만드는 데 들어간 YAML 몫)의 내용 구조(나열, 순서, 비교, 계층, 순환, 수치 크기, 구성비, 시간)를 드러내는가, 아니면 반대로나 다른 종류로 읽히게 하는가?
이 컴포넌트의 표현 = result_meta.categories 의 카테고리이고, 그림에서 binding 의 글이 든 영역이다. 그 밖의 영역(binding 글이 없는 차트와 그 범례, 수치, 다른 카드)은 경계 밖이라 이 컴포넌트의 표현이 아니다. 비교 기준은 유저 원문이 아니라 page_yaml 이다. page_yaml 은 이 장(이 컴포넌트)을 만드는 데 들어간 YAML 몫이다. 유저 원문 전체나 L2 의 형제 컴포넌트, 나눠 담기(리스트, 표)의 다른 장으로 간 항목은 들어 있지 않다. 그것이 여기 없는 것은 누락이 아니다. 다른 장 몫의 구조는 이 컴포넌트가 담을 몫이 아니다.
fit: 맡은 몫의 구조가 표현에 드러난다(단계는 순서로, 비교는 나란히, 수치는 크기로, 짝은 짝으로).
plain: 구조를 드러내지 않을 뿐 거스르지 않는다. 마지막 fallback(일반 목록, 긴 글, 강조문)으로 담긴 것, page_yaml 에 구조가 없는 것(한 줄, 지시문)이 여기다.
mismatch: 표현이 내용 구조를 반대로나 다른 종류로 읽히게 한다. 순서 없는 나열에 진행 표현(단계 화살표, 흐름선, 「1단계」 「Step」 같은 단계 표지)이 붙어 단계처럼 읽힘, 부분과 전체를 독립 항목 비교로 보임, 계층 방향이 반대, 순환을 직선 단계로 보임, 시간 축 방향이 반대, 병렬 항목이 템플릿 배치로 서로 다른 급이나 묶음처럼 갈라짐, 표나 계층을 목록으로 바꾸며 관계가 깨져 어느 항목의 값인지 안 읽힘.
예시(결정 9): 순서 없는 나열에 번호(01, 02, 03)만 붙은 것은 구분 표식이라 결함이 아니다(fit 또는 plain). 같은 나열이 화살표나 흐름선으로 이어지거나 「1단계, 2단계」로 적히면 mismatch 다.
예시(결정 10): 표나 계층이 목록으로 바뀌어도 목록 안에서 page_yaml 의 관계(항목과 속성의 짝, 상하 관계)가 읽히면 plain 이다(예: 「A 요금제: 월 1만 원, 10GB」). 관계가 깨져 누구의 값인지 안 읽히면 mismatch 다(예: 요금제 이름과 가격이 따로 떨어진 목록으로 나와 짝이 안 보임).
따지지 않는 것: marker 번호와 항목 번호의 어긋남, 같은 머리 반복과 넘친 항목의 다른 유닛 배치, 설명의 소속과 항목 순서(E5 몫), 크기와 강조의 급(E6), 색과 그림 요소의 어울림, 경계 밖 차트, 위성 자리 임시 문구.
입력 자료
page_yaml binding result_meta result_thumb
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
human
모델 라벨(사람 대신)
410 단위 · fable+gpt55 110 · fable-N(단독) 300
정답 대조 수 · 양성
409 · 양성 31
정밀도
0.29
재현율
0.32
F1
0.31
반복 일치(3회 최빈 비율)
0.88
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 73.3% · 결함 여부 94.7%
평가기 의심
9% (30 문서 4절 근거 분류)
사람 검수
hold3 사람 라벨 30(mryu, 10/26, 검토 뒤 최종본) · 표본 결함 6/30 = 20.0% [9.5–37.3]
정밀도 0.30 [0.13–0.51] (6/20) · 재현율 정하지 못함 [0.09–0.93] · 일치 93.3% (표본 그대로 16/30) · 층 가중
보정 2.9% [2.6–28.0] → 보류 유지(표본 n 필요) · 종전(모델 라벨) 보정 8.7% · 검토 전 답 기준 9.8% [3.9–35.8]
모델 mismatch 20 중 사람 결함 6(정밀도 0.30), fit · plain 10 중 0. 측정 9.6% 의 약 70% 는 측정기 몫이고 확인된 거짓 구조는 약 2.9% 다. 모델 음성(전체의 90%)의 놓침을 10 단위로는 가리지 못해 구간 상한이 28% 다. 더 필요한 라벨: mismatch 에서 약 59 더(정밀도 반폭 10%p), fit · plain 에서 약 250(놓침 상한 1%p) 또는 약 120(2%p). 출처 48 문서
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
9.57% × 0.29 ÷ 0.32 = 8.72%

한계

  • 관문(25 문서 3절): F1 0.31
  • 30 문서 4.1: 정밀도 0.29. 근거: 화살표와 연결선 29%, STEP 표지 14%, 평가기 의심 9%

결과

9.57% [9.23–9.92]

2,722/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
내용 오류
목표 수준
0
기준값과 출처
바닥 사람 라벨 30 보정, 판정 선 3.5%(제안)
측정값 [95%]
9.57% [9.23–9.92] · 2,722/28,445 장
보정값
2.9% [2.6–28.0] 사람
판정
보류 유지(표본 n 필요). 사람 라벨 30 · 보정 2.9% [2.6–28.0]
신뢰도 표지
사람 라벨 30 · 정밀도 0.30 · 라벨 409 · 정밀도 0.29 · 반복 0.88
25 문서 판정
측정 중
쉬운 / 어려운 조건
9.3% / 12.3%
찾기 차이 / 확인 차이
+2.9 [-0.9–7.0] / +3.1 [-0.5–7.5]
목표(제안) · 근거
3–5% · 규약
규약 참고(53)
3–5%
도달 · 거리
(미달) · +4.57%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
9.15% [8.2–10.2] 273/2,985
답 분포(30c, 운영 조건 셀)
fit: 42,772(49.7%), plain: 34,003(39.5%), mismatch: 9,240(10.7%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-h2 컴포넌트 카테고리 2.2 순서와 흐름 밖 대 컴포넌트 카테고리 2.2 순서와 흐름8.31% 2,128/25,60820.9% 594/2,83715 문서 E2 「흐름 템플릿 오선택」과 같은 자리
I-h5 컴포넌트 카테고리 2.5 텍스트와 사람 대 컴포넌트 카테고리 2.5 텍스트와 사람 밖1.49% 75/5,01811.3% 2,647/23,427텍스트 종은 구조를 표현하지 않아 어긋날 구조가 없다(제안)

채택 연결

채택 오즈비 (95%)
0.75 (0.62–0.92)
채택 장 결함 % / 비채택 장 결함 %
11.0 / 13.3
이 카드 하나만 고칠 때 KR1
+0.9 (0.2–1.5)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

E2 사례 결과 그림
결과

모델 답 어긋남 · 반복 3회 중 최빈 비율 1.00 · 순위 10 · 유형 List · 단위 38872405188a790ac51fdb0995671e62#0#r10

모델 근거(3회 중 첫 답): 순서 없는 세 차원의 나열에 1·2·3 번호를 진행 표지처럼 카드 위에 붙여 단계적 순서로 읽히게 한다.

E2 사례 결과 그림
결과

모델 답 어긋남 · 반복 3회 중 최빈 비율 1.00 · 순위 9 · 유형 Steps · 단위 46404243426ba139213e40193b8b0f65#1#r9

모델 근거(3회 중 첫 답): 「코딩」が「조건 설정」の下位項目ではなく、同列の箇条書きに見える。

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E2(옛 judge agent_1)
  • 22-overall-cards.md §3
  • 30-human-truth-fable.md(라벨러 규칙: 경계 밖 차트 제외)
  • 46-e1e2-split-and-targets.md §3.4(새 E2 질문 초안), 47-decisions-1020.md 결정 2, 9, 10
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E2.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
종합 · 장 단위 · 기본 m

E3 채워지지 않은 자리가 보임

내용 오류 전달 저하 보류 판정 없음 18.6% [18.2–19.1] 장

무엇

이름
채워지지 않은 자리가 보임
링크
종합
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
내용 오류 전달 저하
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
complete완성
satellite_only위성 자리만 비어 있음
body_blank본문 자리 비어 있음결함전달 저하
outside_left경계 밖 잔존결함내용 오류
template_left템플릿 글 남음결함내용 오류

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
③ 공급 부족 몫이 하한. R4 공급 분해는 상위 10 에서 162/2,985(5.4%, 38 문서 2.1, 옛 규칙)
주 근거
③ 구조 하한
53 목표(제안)
8–10%
53 달성
미달

무엇을 잡나

유저가 받는 DO 전체에 본문 빈 자리(임시 문구, 빈 칸), 원본 템플릿 글, 경계 밖 템플릿 데이터(차트, 표의 수치와 범례)가 보이는 일을 잡는다. 이것이 보이지 않는 것은 대치 결과의 최소 조건이다(기본품질 13 1.1). 종합 결과이고 범위는 결과에 들어간 DO 전체이며(평가틀 47 결정 2, 평가틀 37 6절 제안 1), 빈 자리는 이 장의 YAML 몫에 내용이 있는 자리만 센다(유저 결정 10/23). 위성 자리 임시 문구와 항목 수에 맞는 구조 토큰은 결함이 아니고(평가틀 47 결정 11, 12), 원인 쪽은 P2(색인 미결속), D6(대치 안 덮음), R8(경계 밖 후보)이 나눠 잰다.

어떻게

질문

결과에 실제로 들어간 DO 전체(그림에 보이는 컴포넌트 전부)가 page_yaml(이 장을 만드는 데 들어간 YAML 몫) 내용으로 채워져 있는가, 빈 자리(임시 문구, 빈 칸)나 원본 템플릿의 글, 템플릿 데이터가 보이는가?
범위: 그림은 DO 전체가 1920x1080 가운데 놓인 것이고, 보이는 것은 전부 결과에 들어간 부분이다. 경계 안 = frame_tree 의 노드(질의를 담은 부분), 경계 밖 = outside_nodes 의 노드(같은 DO 에 함께 들어간 나머지)다.
자료 읽는 법: binding 의 text 가 경계 안에 넣은 사용자 글이다. frame_tree 의 text 는 대치 전 템플릿 원문이라, 그 글이 그림에 그대로 보일 때만 「남은 것」이다. binding 에 sheet_id 가 있는 노드는 사용자 글로 바뀐 자리이므로 frame_tree 에 적힌 원문은 남은 것이 아니다. template_left 와 outside_left 의 근거에는 그림에서 직접 읽은 글을 적고, frame_tree 나 outside_nodes 에만 있는 글을 근거로 쓰지 않는다. outside_nodes 의 template_text 는 대치 전 원문, now 는 대치 뒤 글이다(now 가 null 이면 원문이 그대로 남는다). element 가 chart 나 table 인 노드는 데이터 요소라 그 안의 수치, 축, 범례는 글 노드가 아니다(대치되지 않으면 템플릿 데이터가 그대로 보인다). 임시 문구는 placeholder_table 의 문구(「제목을 입력해주세요.」, 「부제목 입력」, 「설명을 입력해주세요.」, 「내용」 등)다.
자리: 위성 자리 = 컴포넌트 전체에 붙는 제목, 부제, 설명 자리(항목 밖. outside_nodes 의 satellite true 포함). 본문 자리 = 경계 안 항목(카드, 단계, 행, 칸) 안의 글 자리.
답 고르기(위에서부터 먼저 맞는 것):
(1) template_left: 경계 안에 사용자 글도 임시 문구도 아닌 템플릿 글이 보인다. page_yaml 과 다른 언어의 낱말이 붙은 marker(レベル1), 템플릿의 안내문(「이곳에 ... 입력해 보세요」)도 여기다. 구조 토큰(A, B, C 또는 F, A, Q, Q, A, VS 같은 이름표 자리 토큰)은 page_yaml 항목 수와 의미에 맞으면 남은 것이 아니고, 어긋날 때만 template_left 다. 예: 항목 셋에 A, B, C 는 결함 아님. FAQ 가 아닌 내용에 F, A, Q, 항목 둘에 A, B, C 는 template_left(결정 12, D6 의 구조 토큰 제외와 같은 판단). Marker 의 숫자(01, 02)는 여기 아니다.
(2) body_blank: 경계 안 본문 자리에 임시 문구나 빈 자리가 보인다. page_yaml 에 해당 내용이 있는 자리만 센다. page_yaml 은 이 장(이 컴포넌트)을 만드는 데 들어간 YAML 몫이다. 유저 원문 전체나 L2 의 형제 컴포넌트, 나눠 담기(리스트, 표)의 다른 장으로 간 항목은 들어 있지 않다. 그것이 여기 없는 것은 누락이 아니다.
(3) outside_left: 경계 밖에 템플릿 원문 글, 템플릿 데이터(차트, 표, 다이어그램의 수치와 범례), 또는 위성이 아닌 자리의 임시 문구가 보인다. 근거(evidence)에 무엇이 보였는지 종류를 적는다: 임시 문구 / 템플릿 원문 글 / 차트·표·다이어그램 데이터.
(4) satellite_only: 위성 자리(경계 안팎)에만 임시 문구가 있고 나머지는 채워졌다. 위성 자리(부제목, 작은 설명, 캡션)는 유저가 채울 수 있는 보조 자리라 결함이 아니다(결정 11).
(5) complete: 본문 자리가 page_yaml 의 글로 채워졌고 위성 자리에도, 경계 밖에도 임시 문구나 템플릿 글, 템플릿 데이터가 없다.
빈 자리가 아닌 것: page_yaml 항목 수와 의미에 맞는 구조 토큰, page_yaml 에 값이 없어 빈 표 칸, page_yaml 에 설명이 없는 항목(label 만 있는 entity)의 설명 자리가 빈 것, 그림 자리의 사진 삽입 안내(그림 요소), Marker 의 숫자(01, 02), 질의 필드 접두(「label:」), 다른 장(L2 의 형제 컴포넌트, 나눠 담기의 다른 쪽) 몫의 항목이 여기 없는 것, 장식과 배경.
입력 자료
result_thumb page_yaml binding frame_tree outside_nodes placeholder_table
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v7

신뢰도

정답 종류
human
모델 라벨(사람 대신)
377 단위 · fable+gpt55 138 · fable-N(단독) 239
정답 대조 수 · 양성
377 · 양성 46
정밀도
0.31
재현율
0.67
F1
0.43
반복 일치(3회 최빈 비율)
0.90
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 92.0% · 결함 여부 92.0%
평가기 의심
10% (30 문서 4절 근거 분류)
사람 검수
hold3 사람 라벨 30(mryu, 10/26, 검토 뒤 최종본) · 표본 결함 2/30 = 6.7% [1.8–21.3]
정밀도 0.10 [0.02–0.28] (2/20) · 재현율 정하지 못함 [0.03–0.90] · 일치 85.6% (표본 그대로 12/30) · 층 가중
보정 1.6% [1.3–31.0] → 보류 유지(표본 n 필요) · 종전(모델 라벨) 보정 8.7% · 검토 전 답 기준 2.4% [1.9–31.6]
모델 결함 20 중 사람 내용 오류 2(정밀도 0.10), 무결함 10 중 0. 결함 20 은 모두 low 와 기본 강도 답이 갈린 shift 층(992)이라 shift 밖 결함 3,547 은 표본 0 이다. 그 층 정밀도를 shift 와 같게 두면 1.6%, 종전 0.31 이면 4.3%, 전부 참이면 12.8% 라 가르지 못한다. shift 20 에서 사람은 기본 강도와 18/20, low 와 2/20 일치해 강도 정본은 기본 강도다(기본 강도로 다시 세면 내용 오류 13.1%). 더 필요한 라벨: shift 밖 모델 결함(3,547)에서 약 95, 모델 무결함에서 약 250(놓침 상한 1%p) 또는 약 120(2%p). 출처 48 문서
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
18.6% × 0.31 ÷ 0.67 = 8.66%

한계

  • 관문(25 문서 3절): F1 0.43
  • 30 문서 4.1: 정밀도 0.31, 재현율 0.67. 근거: 한국어 템플릿 글 19%, 영어 원문 15%, 구조 토큰 불일치 13%, 평가기 의심 10%

결과

18.6% [18.2–19.1]

5,304/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

행 1/2

등급
내용 오류 결함 답 outside_left, template_left
목표 수준
0
기준값과 출처
바닥 사람 라벨 30 보정, 판정 선 3.5%(제안)
측정값 [95%]
16.0% [15.5–16.4] · 4,539/28,445 장
보정값
1.6% [1.3–31.0] 사람
판정
보류 유지(표본 n 필요). 사람 라벨 30 · 보정 1.6% [1.3–31.0]
신뢰도 표지
사람 라벨 30 · 정밀도 0.10 · 라벨 377 · 정밀도 0.31 · 반복 0.90

행 2/2

등급
전달 저하 결함 답 body_blank
목표 수준
원본 수준
기준값과 출처
4절 행 없음 30 문서 4절 표에 이 결함 답의 행이 없다
측정값 [95%]
2.69% [2.51–2.88] · 765/28,445 장
보정값
—
판정
판정 없음 30 문서 4절 표에 판정 행 없음(8절 1 로 마감 미흡에서 전달 저하로 옮긴 결함 답)
신뢰도 표지
라벨 377 · 정밀도 0.31 · 반복 0.90
25 문서 판정
측정 중
쉬운 / 어려운 조건
18.1% / 24.0%
찾기 차이 / 확인 차이
+8.5 [4.3–13.3] / +3.5 [0.2–7.0]
목표(제안) · 근거
18.14–18.61% · 쉬운 조건(S-d)
규약 참고(53)
8–10%
도달 · 거리
(미달(구간 겹침)) · +0.04%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
15.0% [13.7–16.3] 447/2,985
답 분포(30c, 운영 조건 셀)
complete: 59,282(69.5%), satellite_only: 7,354(8.6%), body_blank: 2,953(3.5%), outside_left: 1,648(1.9%), template_left: 14,098(16.5%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
S-c 질의 dataset 없음 대 질의 dataset 있음15.2% 3,286/21,55229.3% 2,015/6,882표, 차트 질의는 템플릿 칸을 다 못 채운다(05 문서 3.1, 제안 해석)
S-e 질의 List, Steps, QnA, 목차 대 그 밖 질의 유형14.5% 2,175/14,96323.2% 3,126/13,47105 문서 3.1

채택 연결

채택 오즈비 (95%)
0.89 (0.77–1.02)
채택 장 결함 % / 비채택 장 결함 %
20.8 / 21.6
이 카드 하나만 고칠 때 KR1
+0.7 (−0.2 – +1.5)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

E3 사례 결과 그림
결과

모델 답 템플릿 글 남음 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 본문에 page_yaml과 다른 템플릿 문구인 “Upcoming Plans”가 보입니다.

E3 사례 결과 그림
결과

모델 답 경계 밖 잔존 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 HighlightedMessage · 단위 17ca3f4b4960d5c22e3465bd81a5bcad#0

모델 근거(3회 중 첫 답): 차트에 템플릿 데이터가 보입니다: 95%, 80%, 선 그래프와 범례 ‘학업성취도 (20XX년~20XX년)’.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E3(옛 judge agent_1, agent_2 임시 문구 규칙)
  • 22-overall-cards.md §2, §3
  • eval/human/PACKET_INSTRUCTIONS.md(라벨러 전제 1, 2)
  • 30-human-truth-fable.md(라벨러 규칙: 위성 임시 문구 제외, 한 글자 토큰은 눈에 템플릿 글. 경계 밖 제외 규칙은 v3 에서 범위가 바뀌어 맞지 않는다)
  • 37-residue-attribution.md §2.1(삽입 단위 = DO 전체), §6 제안 1
  • 47-decisions-1020.md 결정 11(위성 임시 문구 결함 아님), 결정 12(구조 토큰은 어긋날 때만)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E3.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
종합 · 장 단위 · 기본 m

E4 글이 다 읽히지 않음

전달 저하 보류 7.48% [7.18–7.80] 장

무엇

이름
글이 다 읽히지 않음
링크
종합
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
readable다 읽힘
partly일부 안 읽힘결함전달 저하
important중요한 글이 안 읽힘결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
③ D8, D9 의 컴포넌트 단위 합이라 그 하한을 따른다
주 근거
③ 구조 하한
53 목표(제안)
3–5%
53 달성
미달

무엇을 잡나

컴포넌트의 글이 끊김, 가림, 겹침, 배경과 섞임 때문에 읽히지 않거나, 표와 차트에 값과 범례가 없어 어느 항목이 얼마인지 읽을 수 없는 일을 잡는다. 넣은 글이 읽히지 않으면 시각 요약이 아니다(기본품질 13 1.1). 종합 결과이고 결과 그림으로 읽힘만 보며, 한글 글자 단위 줄바꿈, 글자 축소, 옅은 글자색은 읽히면 결함이 아니다(E4 v2). 읽혀도 원본 표현이 깨진 것은 T1, T3, D8 이 따로 잰다(기본품질 19 4절).

어떻게

질문

이 컴포넌트의 글이 전부 읽히는가?
안 읽힘으로 세는 것: 글자가 상자나 도형 밖으로 나가 끊김, 다른 글이나 그림 뒤에 가려짐, 글끼리 겹쳐 글자가 섞임, 배경 도형과 섞여 글자 모양이 안 보임, 표와 차트에 값, 범례, 축 라벨이 없어 어느 항목이 얼마인지 읽을 수 없음.
important: 안 읽히는 글이 제목, 항목 이름, 수치, 차트의 값이나 범례 같은 핵심 글이다. partly: 설명 일부, marker 숫자, 보조 글이다. readable: 전부 읽힌다.
세지 않는 것: 한글과 일본어의 글자 단위 줄바꿈(「냉동창/고」, 「관/객」, 「제/안」)과 줄 끝 조사 분리는 읽히면 결함이 아니다(단어 분절은 D9 가 따로 센다). 글자 축소, 색 대비(옅은 글자색), 임시 문구와 템플릿 글(E3 몫), 경계 밖 요소(차트와 그 범례, 다른 카드)의 글, 줄 사이 간격과 여백은 보지 않는다.
입력 자료
result_thumb
측정기
LLM
정답 종류
human
비교 기준
결과 그림만 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
270 단위 · fable+gpt55 135 · fable-N(단독) 135
정답 대조 수 · 양성
269 · 양성 9
정밀도
0.32
재현율
0.67
F1
0.43
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 90.0% · 결함 여부 90.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
7.48% × 0.32 ÷ 0.67 = 3.55%

한계

  • 관문(25 문서 3절): F1 0.43, 양성 9
  • 30 문서 4.2: 정밀도 0.32, 보정 3.5%

결과

7.48% [7.18–7.80]

2,129/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 정밀도 0.32, 보정 3.5%
측정값 [95%]
7.48% [7.18–7.80] · 2,129/28,445 장
보정값
3.5%
판정
보류
신뢰도 표지
라벨 269 · 정밀도 0.32 · 반복 0.98
25 문서 판정
측정 중
쉬운 / 어려운 조건
7.4% / 8.5%
찾기 차이 / 확인 차이
+1.0 [-1.2–3.7] / +1.1 [-1.7–3.9]
목표(제안) · 근거
3–5% · 규약
규약 참고(53)
3–5%
도달 · 거리
(미달) · +2.48%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
6.57% [5.73–7.51] 196/2,985
답 분포(30c, 운영 조건 셀)
readable: 84,080(91.8%), partly: 1,647(1.8%), important: 5,880(6.4%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
I-p1 격자 노드 없음 대 격자(Table, Chart) 노드 있음6.38% 1,573/24,63814.6% 556/3,807표 칸 글은 작고 촘촘하다(제안)
S-e 질의 List, Steps, QnA, 목차 대 그 밖 질의 유형4.22% 632/14,96311.1% 1,497/13,47105 문서 3.1

채택 연결

채택 오즈비 (95%)
0.86 (0.69–1.09)
채택 장 결함 % / 비채택 장 결함 %
7.6 / 8.0
이 카드 하나만 고칠 때 KR1
+0.3 (−0.2 – +0.7)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

E4 사례 결과 그림
결과

모델 답 중요한 글이 안 읽힘 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 제목과 하단 핵심 항목의 오른쪽 글자가 컴포넌트 경계에서 잘려 읽히지 않습니다.

E4 사례 결과 그림
결과

모델 답 일부 안 읽힘 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 Timeline · 단위 4cd89bc7eb7bb1605bc1e469c5a382e7#0

모델 근거(3회 중 첫 답): 원형 마커 안의 숫자 아래쪽이 잘려 일부 읽히지 않지만, 제목과 설명 및 연도는 읽힙니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E4(옛 judge agent_5)
  • 22-overall-cards.md §2(D8, D9 의 컴포넌트 단위 합)
  • eval/human/PACKET_INSTRUCTIONS.md(라벨러 전제 2, 디자인은 범위 밖)
  • 30-human-truth-fable.md(라벨러 규칙: 한글 글자 단위 줄바꿈 제외, 색 대비 제외)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E4.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
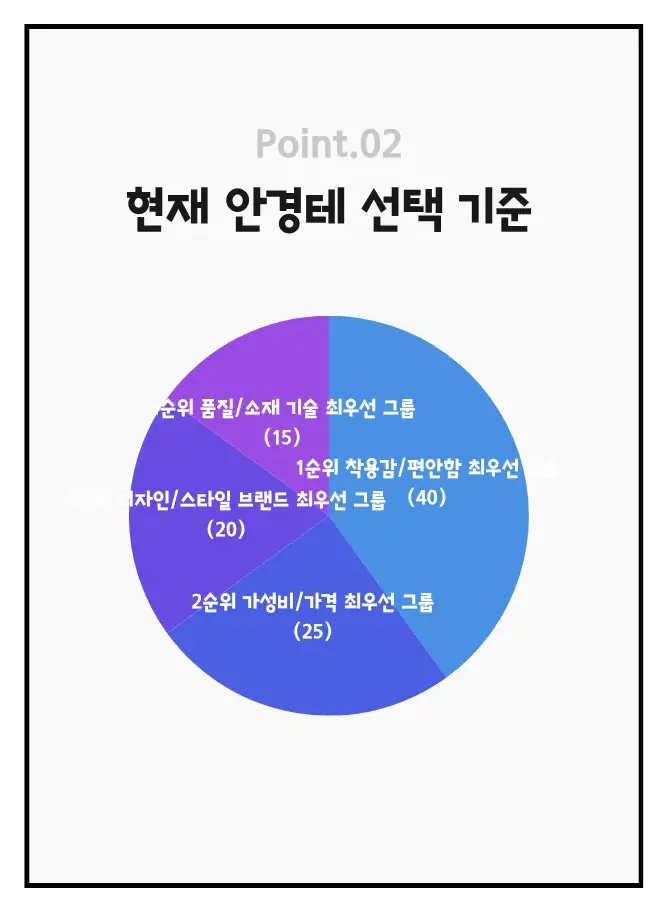
종합 · 장 단위 · 기본 m

E5 정보 구조와 순서가 흐려짐

전달 저하 보류 10.5% [10.1–10.8] 장

무엇

이름
정보 구조와 순서가 흐려짐
링크
종합
단위(셀)
장
기본 m
기본 m 측정 중(값만)
등급
전달 저하
카드 상태
status fix · tier measuring

결함 답과 등급

답뜻결함등급
same그대로
blurred구조 어긋남결함전달 저하
reversed뒤집힘결함전달 저하

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
④, ② 보조. 소속과 묶음은 판단이 갈린다. 머리 반복 몫이 E2 에서 옮겨 왔다
주 근거
④ 사람 한계
53 목표(제안)
5–10%
53 달성
미달

무엇을 잡나

이 장의 YAML 몫의 정보 구조(항목 순서, 설명이 붙은 항목, 묶음)가 컴포넌트에서 흐려지는 일(설명이 엉뚱한 항목에 붙음, 한 항목의 이름과 설명이 다른 칸으로 떨어짐, 순서나 단계 방향이 반대로 읽힘)을 잡는다. 원문의 순서와 소속이 그대로 읽히는 것은 대치가 지킬 VS 개념이다(기본품질 13 1.1). 종합 결과이고 비교 대상은 이 장의 YAML 몫(유저 결정 10/23), 범위는 경계 안이다(평가틀 47 결정 2). 크기, 굵기 같은 디자인은 보지 않고(평가틀 40 Q8) 글자 위계는 T6, 생성 YAML 의 순서는 G4 몫이다.

어떻게

질문

page_yaml(이 장을 만드는 데 들어간 YAML 몫)의 정보 구조(항목 순서, 설명이 어느 항목에 붙는지, 묶음)가 이 컴포넌트에 그대로 담겼는가? 보는 것은 정보 구조뿐이고 디자인(크기, 굵기, 글꼴, 배치 모양)은 보지 않는다.
비교 대상은 이 컴포넌트에 담긴 몫뿐이다. binding 의 text 가 이 컴포넌트에 넣은 글이고, 비교 기준은 유저 원문이 아니라 page_yaml 이다. page_yaml 은 이 장(이 컴포넌트)을 만드는 데 들어간 YAML 몫이다. 유저 원문 전체나 L2 의 형제 컴포넌트, 나눠 담기(리스트, 표)의 다른 장으로 간 항목은 들어 있지 않다. 그것이 여기 없는 것은 누락이 아니다. 다른 장 몫의 항목이 여기 없는 것은 빠짐이 아니고 이 질문의 대상도 아니다(빠짐은 E1 몫). 담긴 항목끼리의 구조만 본다. binding 의 글이 없는 영역(차트와 그 수치, 다른 카드)은 경계 밖이라 이 컴포넌트가 아니다.
same: 담긴 항목이 page_yaml 순서대로 읽히고, 각 설명이 page_yaml 에서 붙어 있던 항목에 붙어 있고, page_yaml 에서 한 묶음이던 항목이 한 묶음으로 있다.
blurred: 설명이 엉뚱한 항목에 붙음(다른 항목의 설명이 이 항목 칸에 있음), page_yaml 의 한 묶음이 갈라짐(한 항목의 이름과 설명이 다른 칸으로 떨어짐, 한 묶음 항목이 서로 다른 묶음으로 나뉨).
reversed: page_yaml 순서가 뒤바뀜(항목 순서가 바뀜, 계단이나 단계의 방향이 반대로 읽힘).
세지 않는 것(디자인이라 결함 아님): 항목 이름과 설명이 같은 크기나 같은 굵기로 보임, 「이름: 설명」을 한 줄로 이어 쓴 것, 글자 크기나 굵기의 급, page_yaml 의 서식 지시(「(작게)」 등)를 따르지 않은 것. 그 밖에 세지 않는 것: 문서 제목이 빠지거나 다른 글이 제목 자리에 든 것(D4 몫), 생성이 붙인 표 머리글(「항목」)이나 제목 글, 위성 자리 임시 문구(E3 몫), 원형 배치나 안 보이는 라벨(E2, E4 몫), 경계 밖 차트, 뒤섞인 연표를 연도순으로 정렬한 것, 출처나 메모 같은 부가 문장 생략.
입력 자료
page_yaml binding result_thumb
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
human
모델 라벨(사람 대신)
266 단위 · fable+gpt55 131 · fable-N(단독) 135
정답 대조 수 · 양성
266 · 양성 65
정밀도
0.69
재현율
0.17
F1
0.27
반복 일치(3회 최빈 비율)
0.98
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 87.3% · 결함 여부 88.7%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
미달 · 측정 중
보정 식(참고)
10.5% × 0.69 ÷ 0.17 = 42.5%

한계

  • 관문(25 문서 3절): F1 0.27
  • 30 문서 4.2: 정밀도 0.69, 재현율 0.17

결과

10.5% [10.1–10.8]

2,975/28,443 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
전달 저하
목표 수준
원본 수준
기준값과 출처
바닥 W 값 없음 · 정밀도 0.69, 재현율 0.17
측정값 [95%]
10.5% [10.1–10.8] · 2,975/28,443 장
보정값
—
판정
보류 (측정 어긋남)
신뢰도 표지
라벨 266 · 정밀도 0.69 · 반복 0.98
25 문서 판정
측정 중
쉬운 / 어려운 조건
9.7% / 18.4%
찾기 차이 / 확인 차이
+4.9 [-0.7–11.2] / +12.4 [5.9–20.0]
목표(제안) · 근거
9.70–10.06% · 쉬운 조건(잠정)(S-d)
규약 참고(53)
5–10%
도달 · 거리
(미달) · +0.40%p
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
15.6% [14.4–17.0] 466/2,985
답 분포(30c, 운영 조건 셀)
same: 76,408(89.1%), blurred: 8,518(9.9%), reversed: 836(1.0%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
M-list 장 범위 리스트 나눠 담기 밖 대 장 범위 리스트 나눠 담기5.94% 1,239/20,84623.2% 1,718/7,408나눠 담기로 묶음 계층이 쪽 사이에서 끊긴다(제안, 15 문서 E5 「묶음 계층 평탄화」와 같은 자리)
I-c 반복 묶음 없음 대 RLSC 반복 묶음 있음3.57% 423/11,86015.4% 2,552/16,583반복 유닛에 상위, 하위 항목을 평탄하게 편다(제안)

채택 연결

채택 오즈비 (95%)
0.88 (0.69–1.13)
채택 장 결함 % / 비채택 장 결함 %
9.7 / 10.2
이 카드 하나만 고칠 때 KR1
+0.3 (−0.4 – +0.9)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

E5 사례 결과 그림
결과

모델 답 구조 어긋남 · 반복 3회 중 최빈 비율 1.00 · 순위 6 · 유형 List · 단위 d3f1163bd4bf3400b26881561f11165d#0#r6

모델 근거(3회 중 첫 답): ‘스토리 적극 활용’의 네 항목이 두 카드로 나뉘어 한 묶음이 갈라졌습니다.

E5 사례 결과 그림
결과

모델 답 뒤집힘 · 반복 3회 중 최빈 비율 1.00 · 순위 10 · 유형 List · 단위 f4644f67cc693a22cb2f343ee438873f#1#r10

모델 근거(3회 중 첫 답): page_yaml은 루카스 부인 다음 샬럿 루카스 순서지만, 컴포넌트에서는 샬럿 루카스가 먼저 나옵니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E5(옛 judge agent_3, agent_2 읽기 순서)
  • eval/human/PACKET_INSTRUCTIONS.md(라벨러 전제 1, 나뉜 것은 결함 아님)
  • 30-human-truth-fable.md(라벨러 규칙: 경계 밖 제외, 위성 임시 문구 제외)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E5.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
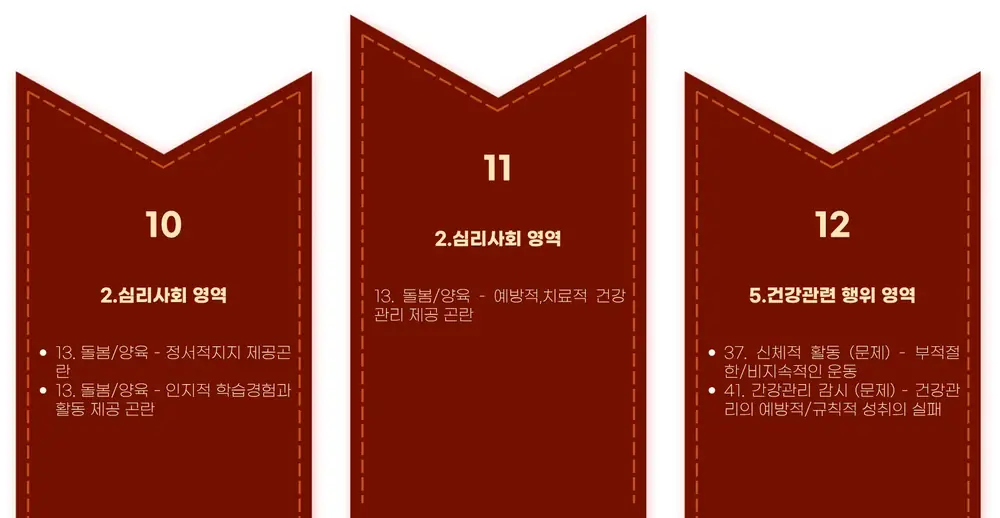
종합 · 장 단위 · 기본 m 밖

E6 (참고) 구성이 어색함

마감 미흡 기본 밖 21.3% [20.8–21.8] 장

무엇

이름
(참고) 구성이 어색함
링크
종합
단위(셀)
장
기본 m
기본 m 밖 응용 참고(13 문서 1.4)
등급
마감 미흡
카드 상태
status ref · tier range

결함 답과 등급

답뜻결함등급
natural자연스러움
awkward어색한 곳 있음결함마감 미흡
broken글 배치가 깨짐결함마감 미흡

기본 m 근거(53 문서)

절
1.6 아래 문단(보드 제외, 근거 열 없음)
근거
자료 없음
주 근거
자료 없음
53 목표(제안)
자료 없음
53 달성
자료 없음

무엇을 잡나

글을 바꿔 넣은 컴포넌트의 글 배치가 어색한 일, 곧 유닛 간 글 양 균형이 무너지거나 유닛 안 여백이 크게 비는 일을 참고로 본다. 요소 대치와 색상 대치가 아직 없어 디자인 완결은 기본 품질 밖이라 응용 참고 카드로 두고 기본 m 에 넣지 않는다(메모리 feedback-component-not-page-scope, 기본품질 13 1.4). 원본 대조 없이 결과 그림만 보며, 정렬은 T4, 글자 크기는 T3 로 기본 m 에 들어갔으므로 E6 에는 남은 몫만 남는다(기본품질 19 4절, 8절). 질문의 정렬 예시는 다음 판에서 빼는 쪽이다(T3, T4 와 겹침, 유저 결정 10/24). 질문 자체는 이번에 고치지 않았다.

어떻게

질문

글을 바꿔 넣은 이 컴포넌트가 글 배치만 보면 자연스러운가, 어색한가?(정렬, 유닛 간 글 양의 균형, 유닛 안 여백) 색과 그림 요소의 어울림은 묻지 않는다(요소 대치와 색상 대치 미적용)
awkward 의 예: 유닛 안에 글이 위쪽에만 몰려 아래가 크게 빔, 넓은 상자에 짧은 글이 작게 놓임, 글머리 간격이 고르지 않음, 글이 한쪽 가장자리에 붙어 좌우 여백이 비대칭, 항목이 흩어져 읽기 흐름이 안 보임, 같은 급 항목이 다른 급 자리에 놓여 배치가 치우침.
어색함이 아닌 것: 한글 글자 단위 줄바꿈(E4, D9 몫), 원문의 글 양 차이에서 온 유닛 간 불균형(한 항목은 두 줄, 다른 항목은 한 글자), 원문에 값이 없어 빈 표 칸, 위성 자리 임시 문구 자체, 경계 밖 요소(차트, 다른 카드), 그림 위의 안내 문구.
입력 자료
result_thumb
측정기
LLM
정답 종류
human
비교 기준
결과 그림만 (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v2

신뢰도

정답 종류
human
모델 라벨(사람 대신)
234 단위 · fable+gpt55 99 · fable-N(단독) 135
정답 대조 수 · 양성
233 · 양성 54
정밀도
0.60
재현율
0.48
F1
0.54
반복 일치(3회 최빈 비율)
0.92
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 66.0% · 결함 여부 68.0%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
자료 없음
보정 식(참고)
21.3% × 0.60 ÷ 0.48 = 26.8%

한계

자료 없음

결과

21.3% [20.8–21.8]

6,063/28,444 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

등급
마감 미흡
목표 수준
기본 밖
기준값과 출처
기본 밖 기본 판정 밖(30 문서 3.2)
측정값 [95%]
21.3% [20.8–21.8] · 6,063/28,444 장
보정값
—
판정
기본 밖 기본 판정 밖, 값만 보인다(30 문서 3.2)
기본 m
기본 m 밖(basic_m.yaml not_basic_m). 판정은 내되 기본 m 집계에 넣지 않는다
신뢰도 표지
라벨 233 · 정밀도 0.60 · 반복 0.92
25 문서 판정
자료 없음
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
21.5% [20.1–23.1] 643/2,985
답 분포(30c, 운영 조건 셀)
natural: 69,252(76.8%), awkward: 18,114(20.1%), broken: 2,806(3.1%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
M-list 장 범위 리스트 나눠 담기 밖 대 장 범위 리스트 나눠 담기18.3% 3,817/20,84729.5% 2,189/7,408제안 해석 없음
I-p1 격자(Table, Chart) 노드 있음 대 격자 노드 없음12.0% 456/3,80722.8% 5,607/24,637제안 해석 없음

채택 연결

자료 없음

사례

E6 사례 결과 그림
결과

모델 답 글 배치가 깨짐 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 제목과 하단 글머리표 문장이 오른쪽 가장자리에서 잘려 글이 온전히 보이지 않습니다.

E6 사례 결과 그림
결과

모델 답 어색한 곳 있음 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 PieChart · 단위 acdc01f2e97cc5f213d64060c29c7bd8#1

모델 근거(3회 중 첫 답): 원형 차트의 항목 글자들이 조각 경계를 가로질러 서로 겹치고 바깥으로 삐져나와 읽기 어렵습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E6(옛 judge agent_7 중 글 배치 몫)
  • 22-overall-cards.md §0 전제 2
  • 30-human-truth-fable.md(참고 카드, F1 0.74)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E6.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
종합 · 장 단위 · 기본 m 밖

E7 시각 요약으로 쓰지 않겠음

보드 밖 20.4% [20.0–20.9] 장

무엇

이름
시각 요약으로 쓰지 않겠음
링크
종합
단위(셀)
장
기본 m
기본 m 밖 머리 지표(13 문서 1.3)
등급
— (결함 답에 등급을 매기지 않는 카드, 30 문서 3.1)
카드 상태
status fix · tier range

결함 답과 등급

답뜻결함등급
use쓰겠다
fix고쳐 쓰겠다
not_use안 쓴다결함

기본 m 근거(53 문서)

절
1.2–1.6 운영 기준 카드
근거
3절
주 근거
자료 없음
53 목표(제안)
3절(10–15% 제안, 장기 참고 5%, 53 149행)
53 달성
정할 수 없음(머리 지표)

무엇을 잡나

결과에 들어간 DO 전체를 이 장의 YAML 몫의 시각 요약으로 그대로 쓰겠는지, 글만 조금 손보면 쓰겠는지, 안 쓰겠는지를 묻는 총평이다. 다른 카드와 더하지 않는 맨 위 판정이라 머리 지표로 두고 기본 m 과 운영 도달 계산에서 뺀다(기본품질 13 1.3, 평가틀 40 4절). 범위는 유저가 받는 DO 전체이고(평가틀 47 결정 2) 비교 대상은 이 장의 YAML 몫이다(유저 결정 10/23). 페이지 나머지와 다른 장 몫은 유저가 채운다는 전제이고, 「값 없음」의 유저 경험 영향은 여기서 반영한다(평가틀 47 결정 8).

어떻게

질문

결과에 실제로 들어간 DO 전체(그림에 보이는 것 전부)를 page_yaml(이 장을 만드는 데 들어간 YAML 몫)의 시각 요약으로 그대로 쓰겠는가? 페이지의 나머지(DO 밖 여백, 페이지 제목)와 다른 장(형제 컴포넌트, 나눠 담기의 다른 쪽) 몫은 유저가 채운다는 전제다. page_yaml 은 이 장(이 컴포넌트)을 만드는 데 들어간 YAML 몫이다. 유저 원문 전체나 L2 의 형제 컴포넌트, 나눠 담기(리스트, 표)의 다른 장으로 간 항목은 들어 있지 않다. 그것이 여기 없는 것은 누락이 아니다.
범위: 그림은 DO 전체가 1920x1080 가운데 놓인 것이다. 경계 안 = 질의를 담은 부분(binding 의 글이 든 자리), 경계 밖 = outside_nodes 의 노드(같은 DO 에 함께 들어간 나머지)다. outside_nodes 의 template_text 는 대치 전 원문, now 는 대치 뒤 글(null 이면 원문이 그대로 남음), element 가 chart 나 table 이면 데이터 요소다. 유저는 경계 밖까지 포함한 DO 전체를 받는다.
use: 그대로 써도 page_yaml 의 내용과 구조가 전달되고 DO 의 나머지가 방해하지 않는다. 위성 자리(부제, 설명)의 임시 문구, 한글 글자 단위 줄바꿈, 작은 여백 불균형은 그대로 쓰는 쪽이다.
fix: 글만 조금 손보면 쓴다. 손질 = 임시 문구 한두 개를 지우거나 채우기, 줄바꿈 고치기, 글 하나를 옆 칸으로 옮기기, 경계 밖의 템플릿 글 한두 줄 지우기, 표의 「값 없음」 칸 몇 개를 지우거나 채우기. 본문 내용과 구조는 맞다.
not_use: 내용이나 구조를 다시 넣어야 하거나, 지워야 할 것이 많다. 다음 가운데 하나면 not_use 다. 본문 자리에 임시 문구나 템플릿 글이 남음. 맡은 항목이나 수치가 빠지거나 읽을 수 없음. 순서나 위계가 틀리게 읽힘(단계 순서가 안 보임, 같은 제목이 두 칸에 반복돼 단계 수가 달라짐, 라벨이 항목 급으로 내려가거나 항목 하나가 전체 제목으로 올라감). 표현이 내용 구조를 반대로 읽히게 함. 질의 필드 이름(「label:」) 같은 편집 흔적이 본문에 들어감. 글이 상자 밖으로 넘쳐 읽기 어려움. page_yaml 의 뜻이 사라짐. 경계 밖에 이 장 내용과 무관한 템플릿 차트, 표, 다이어그램 데이터나 템플릿 글 덩어리가 남아 유저가 이 장의 내용으로 오해하거나 큰 손질 없이는 쓸 수 없음.
예시(결정 8): 표의 빈 칸이 「값 없음」으로 여러 칸 적힌 것은 뜻을 바꾸지 않지만 유저 경험을 해친다. 몇 칸이면 fix, 표의 대부분이 「값 없음」이라 읽기 어려우면 not_use 로 판단 안에서 반영한다.
입력 자료
page_yaml binding result_thumb outside_nodes
측정기
LLM
정답 종류
human
비교 기준
그 장의 page_yaml (입력 이름으로 나눔)
범위
top10
집계 규칙
집계 = ratio
카드 버전
v4

신뢰도

정답 종류
human
모델 라벨(사람 대신)
220 단위 · fable+gpt55 85 · fable-N(단독) 135
정답 대조 수 · 양성
219 · 양성 46
정밀도
0.49
재현율
0.52
F1
0.51
반복 일치(3회 최빈 비율)
0.91
규칙 대조 일치
자료 없음
두 모델 일치(fable 대 gpt55)
150 쌍 · 답 56.7% · 결함 여부 84.7%
평가기 의심
자료 없음
사람 검수
없음 · 사람 직접 라벨 0
관문(25 문서 3절)
자료 없음
보정 식(참고)
20.4% × 0.49 ÷ 0.52 = 19.2%

한계

자료 없음

결과

20.4% [20.0–20.9]

5,807/28,445 장 · 30b agg_2k_3_O(generation 20261024T100739Z-a75be5ef)

기준값과 판정(6장 보드)

보드 밖 카드다.

25 문서 판정
자료 없음
쉬운 / 어려운 조건
자료 없음
찾기 차이 / 확인 차이
자료 없음
목표(제안) · 근거
자료 없음
규약 참고(53)
자료 없음
도달 · 거리
자료 없음
정답 조건 값(표본 250 export)
자료 없음
표본 250 운영 조건
25.5% [23.9–27.1] 760/2,985
답 분포(30c, 운영 조건 셀)
use: 49,193(57.4%), fix: 18,449(21.5%), not_use: 18,063(21.1%)

조건별 관측(2,000 운영)

조건(쉬운 쪽 대 어려운 쪽)쉬운어려운설명(제안 포함)
D-e 슬롯 수 맞물림 대 유닛 공백, items 초과나 부족18.6% 4,681/25,15634.2% 1,126/3,28905 문서 4.1
S-b 질의 List, LongForm, Highlighted 대 그 밖 질의 유형14.1% 2,385/16,87829.6% 3,422/11,55605 문서 3.1

채택 연결

채택 오즈비 (95%)
0.61 (0.51–0.72)
채택 장 결함 % / 비채택 장 결함 %
17.6 / 21.9
이 카드 하나만 고칠 때 KR1
+2.4 (1.6–3.2)%p
출처
31 문서 6.1 · VS 전환 뒤 4일 노출 장 재현, 같은 검색 안 순위 보정

사례

E7 사례 결과 그림
결과

모델 답 안 쓴다 · 반복 3회 중 최빈 비율 1.00 · 순위 1 · 유형 List · 단위 5a6c50684e9367383a5729fb8755af53#0

모델 근거(3회 중 첫 답): 제목과 포트폴리오의 두 번째 항목이 오른쪽 경계를 넘어 잘려 있어 내용을 온전히 읽을 수 없습니다.

E7 사례 결과 그림
결과

모델 답 안 쓴다 · 반복 3회 중 최빈 비율 1.00 · 순위 8 · 유형 ListingTable · 단위 fbc1b6c5b2e858fafcd96f6a92b89664#0#r8

모델 근거(3회 중 첫 답): 경계 밖 표에 템플릿 문구인 ‘기본 타이틀’과 ‘타이틀에 대한 설명을 작성하세요.’가 여러 줄 남아 있어 이 장의 내용으로 오해될 수 있습니다.

사례는 2,000 운영 조건 결함 셀에서 반복 일치가 높은 순으로 자동으로 골랐다(답이 다르면 다른 답 우선). 모델 판정이라 틀릴 수 있다.

출처

  • 22-overall-cards.md §1 E7(총평, BAD 비율의 후임)
  • 22-overall-cards.md §4(조건 b 행동 보조)
  • 30-human-truth-fable.md(라벨러는 「고쳐 쓰겠다」와 「안 쓴다」를 평가기보다 많이 골랐다)
  • 47-decisions-1020.md 결정 2(E7 만 DO 전체), 결정 8(「값 없음」의 유저 경험 영향은 E7 이 반영)
spec_refs(카드 yaml)
자료 없음
spec_refs(manifest)
자료 없음
카드 yaml
/Users/miridih/Documents/mordor/vs-eval-v2/tools/eval/cards/E7.yaml
자료
30b-card-facts.json · 30c-card-questions.md · 25-final-board-2k.md · 30-basic-compliance-criterion.md
묶음 · 채택 연결

대치와 종합 카드 여섯

E2 E5 E3 E4 D8 T1

결함 수와 채택 오즈비(31 문서 6.2)

결함 수항목채택표본 채택 비율 %오즈비 대 0개, 정보 (95%)부트 (95%)모집단 환산 장 채택률 %
02,51571428.415.37
12,54370227.60.87 (0.76–1.00)(0.74–1.02)4.67
21,02025525.00.71 (0.59–0.86)(0.57–0.86)3.81
3 이상55413023.50.66 (0.51–0.85)(0.50–0.87)3.52
추세(개수 1 늘 때)6,6321,8010.87 (0.81–0.93)(0.81–0.94)

등급 조합(31 문서 6.3)

상태항목채택비채택 중 비중표본 채택 비율 %오즈비 대 없음, 정보 (95%)부트 (95%)재현 E7 not_use %
없음2,51571437.328.415.4
전달 저하만2,32861735.426.50.84 (0.72–0.97)(0.69–1.00)20.6
내용 오류 있음(E3 잔존, E2 mismatch)1,78947027.326.30.80 (0.68–0.93)(0.67–0.94)42.6

출처: 31 문서 6.1–6.3 · VS 전환 뒤 4일 실제 노출 장 재현, 같은 검색 안 순위 보정 조건부 로짓